Úvod
V tejto prednáške rozšírime jednoducho typovaný $\lambda$-kalkul o rekurzívne výpočty a rekurzívne údaje. Ukážeme, ako formalizovať konštrukcie známe z programovania a ako z ich pravidiel odvodiť typ aj priebeh výpočtu.
Pomocou operátora fixného bodu vyjadríme rekurzívne funkcie, vzájomnú rekurziu a odvodený tvar letrec. Jeho zavedením však strácame silnú aj slabú normalizáciu ako všeobecné záruky pre správne typované termy. Niektoré z nich nemajú žiadnu cestu k normálnemu tvaru. Na funkcii sčítania ukážeme, ako priebeh a ukončenie konkrétneho rekurzívneho výpočtu zdôvodniť.
Pri zoznamoch prepojíme konštrukciu hodnôt s typovacími a vyhodnocovacími pravidlami. Zavedené operácie výberu hlavičky a chvosta nemajú výpočtové pravidlo pre prázdny zoznam. Preto strácame progres: správne typovaný uzavretý term môže byť zaseknutý, teda nemusí byť hodnotou a zároveň nemusí vedieť vykonať ďalší krok. Naučíme sa tak odlišovať nekonečný výpočet od zaseknutia.
Napokon zavedieme rekurzívne typy ako všeobecný mechanizmus opisu rekurzívnych údajových štruktúr. Porovnáme ekvirekurzívny a izorekurzívny prístup a na reprezentácii prirodzených čísel vysvetlíme zabalenie a rozbalenie hodnôt pomocou fold a unfold. Súvislosť s programovaním ukážeme na príkladoch v OCaml.
Rekurzia v typovanom $\lambda$-kalkule
V druhej prednáške sme rekurziu v netypovanom čistom $\lambda$-kalkule vyjadrili kombinátorom fixného bodu. Curryho $Y$ využíva sebaaplikáciu, ktorá v doterajšom jednoducho typovanom jazyku nie je typovateľná. Problém vidíme už na terme
$$\omega=\lambda x.\ x\ x.$$
Ak by $x$ malo typ $T_1$, jeho použitie ako funkcie by zároveň vyžadovalo typ $T_1\to T_2$. Rovnicu $T_1=T_1\to T_2$ konečné jednoduché typy nespĺňajú. Term
$$\Omega=\omega\ \omega$$
je príkladom divergentného termu, nie kombinátorom fixného bodu. V našom doterajšom jazyku nie je typovateľný. Všeobecný operátor fixného bodu nemožno definovať iba pomocou doterajších konštrukcií jednoducho typovaného $\lambda$-kalkulu; zavedieme ho preto ako nové primitívum.
Fixný bod v typovanom $\lambda$-kalkule
Operátor $\mathsf{fix}$ umožní vyjadriť rekurziu priamo v typovanom jazyku. Syntax rozšírime o jediný nový tvar termu:
$$t::=\ldots\mid\mathsf{fix}\ t.$$
Poznámka
Term $\mathsf{fix}\ v$ nie je hodnota. Hodnotové formy zatiaľ nemeníme.
Typovacie pravidlo:
Vyhodnocovacie pravidlá:
Pravidlo E-Fix najprv vyhodnocuje argument operátora. Keď ním je abstrakcia $\lambda x:T.t$, pravidlo E-FixBeta vykoná substitúciu bez zachytenia $[x\mapsto\mathsf{fix}\ (\lambda x:T.t)]t$. Tým rozvinie jedno rekurzívne volanie. Nejde o obyčajnú aplikáciu s už vyhodnoteným argumentom: E-FixBeta je nové pravidlo jazyka.
Naďalej používame volanie hodnotou z tretej až piatej prednášky. Zápis $t\to t'$ označuje jeden operačný krok a $t\to^*t'$ nula alebo viac krokov. Symbol $\equiv$ budeme používať pri rozvinutí syntaktických skratiek; rovnosť pri vyčíslení substitúcie patrí do metajazyka.
Príklad: Funkcia sčítania plus
Príklad
Majme funkciu sčítania opísanú rekurzívnou rovnicou:
$$ \mathsf{plus}(m,n)= \begin{cases} m & \text{ak } n=0,\\ \mathsf{plus}(m+1,n-1) & \text{ak } n>0, \end{cases} \qquad m,n\in\mathbb N. $$
V každom rekurzívnom volaní zväčšíme prvý argument o jednotku a druhý zmenšíme o jednotku. Keď druhý argument dosiahne nulu, výsledkom je prvý argument. V našom jazyku použijeme už zavedené operácie $\mathsf{succ}$, $\mathsf{pred}$ a $\mathsf{iszero}$ nad vstavaným typom $\mathsf{Nat}$.
Dva argumenty vyjadríme vnorenými abstrakciami. Hľadaná funkcia má spĺňať rovnicu
$$ \mathsf{plus}=\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ \mathsf{plus}\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n). $$
Táto rovnica ešte nedefinuje uzavretý term: na pravej strane je voľná premenná $\mathsf{plus}$. Pravá strana má typ $\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}$ v kontexte $\mathsf{plus}:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}$, ale nie v prázdnom kontexte.
Voľnú premennú nahradíme parametrom a definujeme uzavretú funkciu vyššieho rádu:
$$ g=\lambda f:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}.\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ f\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n). $$
Platí $\vdash g:(\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat})\to\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}$. V tele abstrakcií používame kontext $\Gamma=\{f:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat},m:\mathsf{Nat},n:\mathsf{Nat}\}$. Úplný typovací strom je:
Operátorom $\mathsf{fix}$ teraz definujeme sčítanie:
$$\mathsf{plus}=\mathsf{fix}\ g,\qquad\vdash\mathsf{plus}:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}.$$
Pre výpočet $\mathsf{plus}\ 2\ 3$ overíme typ aplikácie. Nasledujúci strom pracuje s $g$ ako premennou v kontexte $\Delta=\{g:(\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat})\to\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}\}$. Po dosadení vyššie uvedenej uzavretej definície $g$ dostaneme uzavretý term toho istého typu. Číslice sú skratkami numerických hodnôt: $2$ označuje $\mathsf{succ}\;(\mathsf{succ}\ 0)$ a podobne pre $3$.
Vo výpočte už $g$ označuje skratku svojej definície. Vyhodnotenie začneme jej rozvinutím; jednotlivé šípky potom označujú skutočné kroky podľa pravidiel jazyka:
$$ \begin{aligned} &\mathsf{plus}\ 2\ 3\\[0.6em] &\equiv(\mathsf{fix}\ g)\ 2\ 3\\ &\equiv\bigl(\mathsf{fix}\ (\lambda f:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}.\\ &\qquad\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ f\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n))\bigr)\ 2\ 3\\ &\to(\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n))\ 2\ 3\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 2\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 2)\ (\mathsf{pred}\ n))\ 3\\ &\to\mathsf{if}\ \mathsf{iszero}\ 3\ \mathsf{then}\ 2\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 2)\ (\mathsf{pred}\ 3)\\ &\to\mathsf{if}\ \mathsf{false}\ \mathsf{then}\ 2\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 2)\ (\mathsf{pred}\ 3)\\ &\to(\mathsf{fix}\ g)\ (\mathsf{succ}\ 2)\ (\mathsf{pred}\ 3)\\ &\to(\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n))\ (\mathsf{succ}\ 2)\ (\mathsf{pred}\ 3)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 3\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ n))\ (\mathsf{pred}\ 3)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 3\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ n))\ 2\\ &\to\mathsf{if}\ \mathsf{iszero}\ 2\ \mathsf{then}\ 3\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ 2)\\ &\to\mathsf{if}\ \mathsf{false}\ \mathsf{then}\ 3\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ 2)\\ &\to(\mathsf{fix}\ g)\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ 2)\\ &\to(\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n))\ (\mathsf{succ}\ 3)\ (\mathsf{pred}\ 2)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 4\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ n))\ (\mathsf{pred}\ 2)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 4\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ n))\ 1\\ &\to\mathsf{if}\ \mathsf{iszero}\ 1\ \mathsf{then}\ 4\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ 1)\\ &\to\mathsf{if}\ \mathsf{false}\ \mathsf{then}\ 4\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ 1)\\ &\to(\mathsf{fix}\ g)\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ 1)\\ &\to(\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n))\ (\mathsf{succ}\ 4)\ (\mathsf{pred}\ 1)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 5\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 5)\ (\mathsf{pred}\ n))\ (\mathsf{pred}\ 1)\\ &\to(\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ 5\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 5)\ (\mathsf{pred}\ n))\ 0\\ &\to\mathsf{if}\ \mathsf{iszero}\ 0\ \mathsf{then}\ 5\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 5)\ (\mathsf{pred}\ 0)\\ &\to\mathsf{if}\ \mathsf{true}\ \mathsf{then}\ 5\ \mathsf{else}\ (\mathsf{fix}\ g)\ (\mathsf{succ}\ 5)\ (\mathsf{pred}\ 0)\\ &\to5. \end{aligned} $$
Prvý krok používa E-FixBeta: za $f$ dosadíme celý term $\mathsf{fix}\ g$. Potom nasledujú dve aplikácie na hodnoty $2$ a $3$. Pri ďalších volaniach sa najprv rozvinie funkčná časť $\mathsf{fix}\ g$, aplikuje sa na prvý argument a až potom sa vyhodnotí druhý argument $\mathsf{pred}\ n$.
Zápisy $\mathsf{succ}\ 2$ a $3$ označujú tú istú numerickú hodnotu; ich zamenenie v zápise nie je redukčný krok. Rovnako používame skratky $4$ a $5$.
Podmienený výraz vyhodnocuje iba podmienku a vybranú vetvu. Preto sa $\mathsf{pred}\ 3$ začne vyhodnocovať až po výbere vetvy else. Pri nule sa vyberie aktuálny prvý argument $5$ a rekurzívna vetva sa vôbec nevyhodnotí.
Pre prirodzené vstupy sa druhý argument každého rekurzívneho volania zmenší a po konečnom počte volaní dosiahne nulu. Ukončenie tu vyplýva z tohto poklesu a správania if, nie zo samotnej prítomnosti operátora $\mathsf{fix}$.
Strata silnej aj slabej normalizácie
Poznámka
Silná normalizácia vzhľadom na reláciu $\to$ znamená, že z termu nevedie žiadna nekonečná postupnosť vyhodnocovacích krokov. V tretej prednáške sme ju mali zaručenú pre správne typované termy základného jazyka.
Slabá normalizácia vzhľadom na tú istú reláciu vyžaduje existenciu aspoň jednej konečnej redukčnej postupnosti do normálneho tvaru, teda termu, z ktorého už nemožno vykonať ďalší krok.
Pri našej deterministickej relácii volania hodnotou tieto vlastnosti splývajú: každý term má najviac jedného bezprostredného nasledovníka, takže nemôžeme voliť medzi ukončujúcou a nekonečnou redukčnou cestou. Pri nedeterministickej redukcii môžu byť slabá a silná normalizácia odlišné.
Pridaním $\mathsf{fix}$ strácame obe všeobecné záruky. Existuje správne typovaný uzavretý term, ktorý nemá vôbec žiadnu cestu k normálnemu tvaru. Ukončenie konkrétnej rekurzívnej funkcie preto musíme zdôvodniť osobitne.
Príklad
Abstrakcia $\lambda x:T.x$ má typ $T\to T$, preto je správne typovaný aj term $\mathsf{fix}\ (\lambda x:T.x):T$:
Pravidlo E-FixBeta dáva krok
$$ \mathsf{fix}\ (\lambda x:T.x) \to[x\mapsto\mathsf{fix}\ (\lambda x:T.x)]x =\mathsf{fix}\ (\lambda x:T.x). $$
Šípka označuje operačný krok; rovnosť iba vyčísľuje substitúciu. Výsledkom kroku je pôvodný term, takže môžeme pokračovať bez konca:
$$ \mathsf{fix}\ (\lambda x:T.x) \to\mathsf{fix}\ (\lambda x:T.x) \to\mathsf{fix}\ (\lambda x:T.x)\to\cdots. $$
Každý krok vedie opäť k tomu istému termu, preto nemá žiadnu cestu k normálnemu tvaru a nie je ani slabo normalizujúci. Nie je hodnotou ani zaseknutým termom: v každom okamihu môže vykonať ďalší krok.
Samotné rozšírenie o $\mathsf{fix}$ zachováva progres aj stabilitu typov doterajšieho jazyka. Správne typovaný uzavretý term teda môže počítať bez konca, ale pridanie tohto operátora nespôsobuje zaseknutie. Strata normalizačných záruk sama osebe neznamená stratu typovej bezpečnosti.
Nepriama rekurzia
Operátor $\mathsf{fix}$ sa často používa s výsledným funkčným typom, ale typ $T$ v pravidle T-Fix môže byť aj iný. Argument operátora musí mať vždy typ $T\to T$. Pre záznam funkcií tak môžeme vytvoriť obe vzájomne rekurzívne funkcie naraz.
Príklad
Zaveďme najprv rekurzívnu rovnicu pre záznam $isevenisodd$ s funkciami na testovanie párnosti ($iseven$) a nepárnosti ($isodd$):
$$ \begin{aligned} isevenisodd=\langle\;&iseven=\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ \mathsf{true}\ \mathsf{else}\ isevenisodd.isodd\ (\mathsf{pred}\ n),\\ &isodd=\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ \mathsf{false}\ \mathsf{else}\ isevenisodd.iseven\ (\mathsf{pred}\ n)\rangle. \end{aligned} $$
Pravá strana obsahuje voľnú premennú $isevenisodd$. Nahradíme ju parametrom funkcie vyššieho rádu; meno $g$ v tomto príklade označuje túto novú funkciu:
$$ \begin{aligned} g={}&\lambda ieio:\langle iseven:\mathsf{Nat}\to\mathsf{Bool},isodd:\mathsf{Nat}\to\mathsf{Bool}\rangle.\\ &\langle iseven=\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ \mathsf{true}\ \mathsf{else}\ ieio.isodd\ (\mathsf{pred}\ n),\\ &\phantom{\langle}\ isodd=\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ \mathsf{false}\ \mathsf{else}\ ieio.iseven\ (\mathsf{pred}\ n)\rangle. \end{aligned} $$
Typ oboch položiek je $\mathsf{Nat}\to\mathsf{Bool}$, preto platí:
$$ \begin{aligned} \vdash g:{}&\langle iseven:\mathsf{Nat}\to\mathsf{Bool},isodd:\mathsf{Nat}\to\mathsf{Bool}\rangle\\ &\to\langle iseven:\mathsf{Nat}\to\mathsf{Bool},isodd:\mathsf{Nat}\to\mathsf{Bool}\rangle. \end{aligned} $$
Definujeme uzavretý term
$$ r_{ieio}=\mathsf{fix}\ g,\qquad \vdash r_{ieio}:\langle iseven:\mathsf{Nat}\to\mathsf{Bool},isodd:\mathsf{Nat}\to\mathsf{Bool}\rangle. $$
Jedno rozvinutie E-FixBeta vytvorí záznam dvoch abstrakcií, teda hodnotu. Rekurzívne odkazy v ich telách majú tvar $(\mathsf{fix}\ g).isodd$ a $(\mathsf{fix}\ g).iseven$. Pod abstrakciami sa zatiaľ nevyhodnocujú. Funkcie získame projekciami:
$$\vdash r_{ieio}.iseven:\mathsf{Nat}\to\mathsf{Bool},\qquad\vdash r_{ieio}.isodd:\mathsf{Nat}\to\mathsf{Bool}.$$
Napríklad $r_{ieio}.iseven\ 2\to^*\mathsf{true}$ a $r_{ieio}.isodd\ 2\to^*\mathsf{false}$.
Odvodený tvar letrec
Vyššie programovacie jazyky sprístupňujú rekurziu pohodlnejším zápisom. V OCamli slúži na definovanie rekurzívnej funkcie konštrukcia let rec:
Príklad
Nasledujúce sčítanie v OCamli predpokladá nezáporné argumenty. Typ int toto obmedzenie nevynucuje; pre záporný druhý argument by rekurzia neklesala k nule.
utop # let rec plus = fun m -> fun n ->
                if n = 0
                  then m
                  else plus (m + 1) (n - 1);;
val plus : int -> int -> int = <fun>

utop # let rec plus = fun m -> fun n ->
                if n = 0
                  then m
                  else plus (m + 1) (n - 1)
            in plus 2 3;;
- : int = 5
Odvodený tvar $\mathsf{letrec}$ v našom formálnom jazyku definujeme prepisom:
$$ \mathsf{letrec}\ x:T=t_1\ \mathsf{in}\ t_2 \equiv \mathsf{let}\ x=\mathsf{fix}\ (\lambda x:T.t_1)\ \mathsf{in}\ t_2. $$
Na ľavej strane je $x$ viazané v $t_1$ aj v $t_2$. Pravá strana tieto väzby vyjadrí pomocou abstrakcie a už zavedeného let. Ak $\Gamma,x:T\vdash t_1:T$ a $\Gamma,x:T\vdash t_2:T_2$, potom z T-Abs, T-Fix a T-Let odvodíme typ $T_2$ celého prepisu. Symbol $\equiv$ tu definuje syntaktickú skratku, nejde o nové vyhodnocovacie pravidlo.
Príklad
Rekurzívnu rovnicu pre sčítanie zapíšeme pomocou $\mathsf{letrec}$ a funkciu aplikujeme na $2$ a $3$:
$$ \begin{aligned} &\mathsf{letrec}\ \mathsf{plus}:\mathsf{Nat}\to\mathsf{Nat}\to\mathsf{Nat}=\\ &\quad\lambda m:\mathsf{Nat}.\lambda n:\mathsf{Nat}.\ \mathsf{if}\ \mathsf{iszero}\ n\ \mathsf{then}\ m\ \mathsf{else}\ \mathsf{plus}\ (\mathsf{succ}\ m)\ (\mathsf{pred}\ n)\\ &\mathsf{in}\ \mathsf{plus}\ 2\ 3. \end{aligned} $$
Po rozvinutí skratky sa viazaná funkcia vyhodnotí pomocou $\mathsf{fix}$; výsledkom aplikácie je opäť $5$.
Zoznamy
Ďalším užitočným typom je zoznam (list), jedna z najznámejších rekurzívnych údajových štruktúr.
Poznámka
Najprv zavedieme zoznamy ako primitívum jazyka: rozšírime syntax a pridáme typovacie aj vyhodnocovacie pravidlá. V nasledujúcej časti ukážeme všeobecnejší mechanizmus rekurzívnych typov.
Typový konštruktor $\mathsf{List}$ pre každý typ $T$ vytvára typ $$\mathsf{List}\ T$$ konečných zoznamov s prvkami typu $T$.
Zoznamový term zostrojíme pomocou:
- $\mathsf{nil}[T]$ — prázdny zoznam prvkov typu $T$;
- $\mathsf{cons}[T]\ t_1\ t_2$ — konštruktor, kde $t_1$ má typ $T$ a $t_2$ má typ $\mathsf{List}\ T$.
Všetky prvky jedného zoznamu majú rovnaký typ. Môžu to byť čísla, záznamy, varianty aj ďalšie zoznamy. Pri volaní hodnotou je neprázdny zoznam hodnotou až vtedy, keď sú hodnotami jeho hlavička aj chvost.
Príklad
Prvky typu $\mathsf{List}\ \mathsf{Nat}$ konštruujeme napríklad takto:
$$ \begin{array}{l} \mathsf{nil}[\mathsf{Nat}],\\ \mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}]),\\ \mathsf{cons}[\mathsf{Nat}]\ 2\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}])),\\ \mathsf{cons}[\mathsf{Nat}]\ 1\ (\mathsf{cons}[\mathsf{Nat}]\ 2\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}]))). \end{array} $$
Pre čitateľnosť používame hranaté zátvorky a bodkočiarky, rovnako ako pri zoznamoch v OCaml. Zápisy $[][T]$ a $[t_1;\ldots;t_n][T]$ sú iba syntaktické skratky:
$$ \begin{aligned} {}[][T]&\ \overset{\mathrm{def}}=\ \mathsf{nil}[T],\\ {}[t][T]&\ \overset{\mathrm{def}}=\ \mathsf{cons}[T]\ t\ (\mathsf{nil}[T]),\\ {}[t_1;t_2;\ldots;t_n][T]&\ \overset{\mathrm{def}}=\ \mathsf{cons}[T]\ t_1\ ([t_2;\ldots;t_n][T]),\qquad n\ge2. \end{aligned} $$
Prvé zátvorky ohraničujú prvky zoznamu, záverečné $[T]$ označujú ich spoločný typ. Anotácie $[T]$ na primitívach zostávajú súčasťou syntaxe.
Príklad
Predchádzajúce zoznamy zapíšeme stručnejšie:
$$ \begin{aligned} {}[][\mathsf{Nat}]&=\mathsf{nil}[\mathsf{Nat}],\\ {}[3][\mathsf{Nat}]&=\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}]),\\ {}[2;3][\mathsf{Nat}]&=\mathsf{cons}[\mathsf{Nat}]\ 2\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}])),\\ {}[1;2;3][\mathsf{Nat}]&=\mathsf{cons}[\mathsf{Nat}]\ 1\ (\mathsf{cons}[\mathsf{Nat}]\ 2\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{nil}[\mathsf{Nat}]))). \end{aligned} $$
Rovnosti tu znamenajú rozvinutie skratiek, nie vyhodnocovacie kroky.
Príklad
Zoznamy s rôznymi typmi prvkov môžu vyzerať takto:
$$ \begin{array}{l} {}[1;3;5;7;9][\mathsf{Nat}]:\mathsf{List}\ \mathsf{Nat},\\ {}[\mathsf{true};\mathsf{false};\mathsf{false}][\mathsf{Bool}]:\mathsf{List}\ \mathsf{Bool},\\ {}[\langle1,\mathsf{true}\rangle;\langle2,\mathsf{false}\rangle;\langle5,\mathsf{true}\rangle][\mathsf{Nat}\times\mathsf{Bool}]:\mathsf{List}\ (\mathsf{Nat}\times\mathsf{Bool}). \end{array} $$
Pri zozname zoznamov je typom každého prvku $\mathsf{List}\ \mathsf{Nat}$, preto má vonkajší zoznam anotáciu $[\mathsf{List}\ \mathsf{Nat}]$:
$$[[1;3][\mathsf{Nat}];[7;9][\mathsf{Nat}];[1;3;5;7;9][\mathsf{Nat}]][\mathsf{List}\ \mathsf{Nat}]:\mathsf{List}\ (\mathsf{List}\ \mathsf{Nat}).$$
Syntax
Syntax jazyka rozšírime o nové termy, hodnoty a typový konštruktor:
$$ \begin{aligned} t::={}&\ldots\mid\mathsf{nil}[T]\mid\mathsf{cons}[T]\ t\ t\mid\mathsf{isnil}[T]\ t\mid\mathsf{head}[T]\ t\mid\mathsf{tail}[T]\ t,\\ v::={}&\ldots\mid\mathsf{nil}[T]\mid\mathsf{cons}[T]\ v\ v,\\ T::={}&\ldots\mid\mathsf{List}\ T. \end{aligned} $$
Operácia $\mathsf{isnil}[T]\ t$ zistí, či je zoznam prázdny. Operácia $\mathsf{head}[T]\ t$ vyberie prvý prvok neprázdneho zoznamu a $\mathsf{tail}[T]\ t$ vyberie jeho chvost. Správanie oboch výberov na prázdnom zozname rozoberieme po pravidlách.
Typovacie pravidlá
Vyhodnocovacie pravidlá
Pravidlá E-Cons1 a E-Cons2 vyhodnocujú najprv hlavičku a potom chvost. Operácie $\mathsf{isnil}$, $\mathsf{head}$ a $\mathsf{tail}$ najprv vyhodnotia svoj argument na zoznamovú hodnotu; až potom sa použije príslušné pravidlo pre $\mathsf{nil}$ alebo $\mathsf{cons}$.
Príklad
Overme typ a vyhodnoťme term
$$\mathsf{head}[\mathsf{Nat}]\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{cons}[\mathsf{Nat}]\ 8\ (\mathsf{nil}[\mathsf{Nat}]))).$$
Typová kontrola. Číslice sú skratkami numerických hodnôt zavedenými v štvrtej prednáške. Každý krok T-Succ preto odvodzuje napríklad $3:\mathsf{Nat}$ zo $2:\mathsf{Nat}$, lebo $3$ označuje $\mathsf{succ}\ 2$. Úplný strom je:
Vyhodnotenie. Argument je už zoznamovou hodnotou, preto použijeme E-HeadCons:
$$\mathsf{head}[\mathsf{Nat}]\ (\mathsf{cons}[\mathsf{Nat}]\ 3\ (\mathsf{cons}[\mathsf{Nat}]\ 8\ (\mathsf{nil}[\mathsf{Nat}])) )\to3.$$
Strata progresu pri čiastočných operáciách nad zoznamami
Poznámka
Progres vyžaduje, aby každý správne typovaný uzavretý term bol hodnotou alebo mohol vykonať ďalší krok. Pri uvedených pravidlách pre zoznamy táto vlastnosť prestáva platiť: $\mathsf{head}$ ani $\mathsf{tail}$ nemajú výpočtové pravidlo pre prázdny zoznam.
Typ $\mathsf{List}\ T$ nerozlišuje prázdne a neprázdne zoznamy, preto typová kontrola pripustí aj takýto výber. Správne typovaný uzavretý term sa teda môže zaseknúť. Príčinou je neúplnosť týchto operácií v našom rozšírení, nie samotná existencia zoznamového typu.
Príklad
Term $\mathsf{head}[\mathsf{Nat}]\ (\mathsf{nil}[\mathsf{Nat}])$ má typ $\mathsf{Nat}$:
Nie je hodnotou. Argument $\mathsf{nil}[\mathsf{Nat}]$ už žiadny krok nevykoná a pre výber hlavičky prázdneho zoznamu nemáme pravidlo. Term teda nemôže pokračovať a je zaseknutý. Rovnako sa zasekne $\mathsf{tail}[\mathsf{Nat}]\ (\mathsf{nil}[\mathsf{Nat}])$.
Bezpečnejšou alternatívou je úplný rozbor zoznamu s osobitnou vetvou pre prázdny a neprázdny zoznam. Inou možnosťou je výber hlavičky s výsledným typom $\mathsf{Option}(T)$ z piatej prednášky: neprázdny zoznam poskytne prítomný prvok a prázdny zoznam explicitnú neprítomnosť. Tieto alternatívy tu neformalizujeme; ponechávame pôvodné primitíva a ich uvedené pravidlá.
Čo jednotlivé rozšírenia menia
- Rekurzia pomocou $\mathsf{fix}$ ruší silnú aj slabú normalizáciu ako všeobecné vlastnosti správne typovaných termov. Niektoré termy nemajú žiadnu cestu k normálnemu tvaru a vyhodnocujú sa bez konca.
- Čiastočné operácie $\mathsf{head}$ a $\mathsf{tail}$ rušia progres. Výpočet môže dosiahnuť zaseknutý stav, ktorý nie je hodnotou a nemá žiadny ďalší krok.
Stabilita typov zostáva pri oboch rozšíreniach zachovaná: ak $\Gamma\vdash t:T$ a $t\to t'$, potom $\Gamma\vdash t':T$. Zachovanie typu pri vykonanom kroku však nezaručuje existenciu ďalšieho kroku ani konečnosť celého výpočtu. Na vylúčenie zaseknutia potrebujeme okrem stability typov aj progres.
Normálny tvar vzhľadom na $\to$ nemusí byť hodnotou: aj zaseknutý term už nemá žiadny ďalší krok. Preto samotná existencia normálneho tvaru nezaručuje úspešné vyhodnotenie na hodnotu.
Príklad: Typ zoznam v OCaml
Príklad
Hoci OCaml podporuje zoznamy priamo, na demonštráciu definujme vlastný typ zoznamu celých čísel:
utop # type intlist = Nil | Cons of int*intlist;;
type intlist = Nil | Cons of int * intlist

(* Prvky takéhoto typu sú konštruované nasledovne *)
utop # Nil;;
- : intlist = Nil

utop # Cons (1,Nil);;
- : intlist = Cons (1, Nil)

utop # Cons (2,Cons (1,Nil));;
- : intlist = Cons (2, Cons (1, Nil))

(* Funkcie head a tail *)
utop # let head (l:intlist) : int = match l with
| Nil -> 0
| Cons(x,_) -> x ;;
val head : intlist -> int = <fun>

utop # let tail (l:intlist) : intlist = match l with
| Nil -> Nil
| Cons(_,x) -> x ;;
val tail : intlist -> intlist = <fun>

utop # head (Cons (2, Cons (1, Nil)));;
- : int = 2

utop # tail (Cons (2, Cons (1, Nil)));;
- : intlist = Cons (1, Nil)

utop # head (tail (Cons (2, Cons (1, Nil))));;
- : int = 1
Vlastné funkcie sú alternatívnou implementáciou v OCaml: zvolili sme $\mathsf{head}\ \mathsf{Nil}=0$ a $\mathsf{tail}\ \mathsf{Nil}=\mathsf{Nil}$. Nejde o presný ekvivalent formálnej sémantiky vyššie, ktorá pre prázdny zoznam výsledok neurčuje. Nula je tu konkrétna voľba pre int; všeobecný typ $T$ nemusí mať dostupnú predvolenú hodnotu.
Príklad
Vstavaný typ zoznamu v OCaml používa rovnaké konštruktory prázdneho zoznamu a pripojenia prvku, no jeho výpis využíva hranaté zátvorky a bodkočiarky:
utop # #show list;;
type 'a list = [] | (::) of 'a * 'a list

(* Prvky typu zoznam sú uzavreté do hranatých zátvoriek
   a oddelené bodkočiarkou *)
utop # [1;2;45;6];;
- : int list = [1; 2; 45; 6]

(* Operácie head a tail *)
utop # List.hd [1;2;45;6];;
- : int = 1

utop # List.tl [1;2;45;6];;
- : int list = [2; 45; 6]

(* prázdny zoznam *)
utop # [];;
- : 'a list = []

(* :: je infixný operátor cons *)
(* všimnite si výpis v druhom riadku *)
utop # 1::[];;
- : int list = [1]

utop # 2::1::[];;
- : int list = [2; 1]

utop # 2::(1::[]);;
- : int list = [2; 1]

utop # 3::(2::(1::[]));;
- : int list = [3; 2; 1]

utop # List.tl [1];;
- : int list = []
Operácie List.hd [] a List.tl [] vyvolajú výnimku Failure. Ani toto správanie nie je redukčným pravidlom nášho formálneho jazyka; na neprázdnych zoznamoch sa však výber hlavičky a chvosta zhoduje s uvedenými príkladmi.
Rekurzívne typy
Zoznamy sme zaviedli ako primitívum jazyka: rozšírili sme syntax a pridali osobitné typovacie aj vyhodnocovacie pravidlá. Zoznam prirodzených čísel je buď prázdny, alebo pozostáva z čísla a ďalšieho zoznamu prirodzených čísel.
Podobne rekurzívnu štruktúru majú aj stromy či fronty. Keby sme každú takúto štruktúru pridávali ako nové primitívum, museli by sme vždy rozšíriť jazyk a jeho pravidlá.
Rekurzívne typy poskytujú všeobecný mechanizmus, ktorým tieto štruktúry opíšeme pomocou už zavedených typových konštruktorov. Namiesto osobitnej sady pravidiel pre každú štruktúru zavedie jazyk spoločné pravidlá pre rekurzívne typy.
Rekurzívny operátor $\mu$
Rekurzívne typy sú najčastejšie využívané na definíciu rekurzívnych údajových štruktúr. Ich opakované rozbaľovanie môže opisovať nekonečný typový strom. To neznamená, že každá hodnota takéhoto typu je nekonečná: napríklad reprezentácia čísla $3$ bude pozostávať z konečného počtu konštruktorov.
Takéto stromy vytvárajú špecifikáciu rekurzívnej rovnice a typ takéhoto stromu musí spĺňať túto rovnicu.
Rekurzívny operátor $\mu$ umožňuje definície takýchto typov.
Nech $T$ je typový výraz, ktorý môže obsahovať typovú premennú $X$. Zápis $$T' = \mu X. T$$ zavádza typovú skratku $T'$ pre rekurzívny typ $\mu X.T$, ktorý reprezentuje riešenie rekurzívnej špecifikácie $X=T$. Pri izorekurzívnom prístupe bude vzťah k rozbaleniu izomorfizmom, nie rovnosťou typov. Rekurzia je prítomná, ak sa $X$ nachádza voľne v tele $T$ pred jeho zviazaním operátorom $\mu$.
Rekurzívny operátor $\mu$ sa správa obdobne ako $\lambda$ pri $\lambda$-abstrakcii. V zápise: $$\mu X. T$$ $\mu$ viaže typovú premennú $X$ v type $T$. Substitúcia typov, rovnako ako substitúcia termov, musí zabrániť zachyteniu voľných premenných.
Operátor $\mathsf{fix}$ zavádza rekurziu na úrovni termov; $\mu$ zavádza rekurziu na úrovni typov. Tieto dva mechanizmy majú odlišnú úlohu.
Typ prirodzených čísel ako rekurzívny typ
Prirodzené čísla môžeme okrem pôvodného vstavaného typu $\mathsf{Nat}$ reprezentovať aj rekurzívnym typom. Ukážeme dve odlišné reprezentácie:
$$\mathsf{Nat}_{var}=\mu X.[zero:\mathsf{Unit},succ:X],\qquad\mathsf{Nat}_{sum}=\mu X.(\mathsf{Unit}+X).$$
V každom z nasledujúcich samostatných príkladov označíme práve používanú reprezentáciu stručne $Nat$. Tieto typy ani pôvodný vstavaný typ nie sú doslovne identickými typmi jedného jazyka; reprezentujú rovnaké prirodzené čísla odlišnou syntaxou.
Príklad
V programovacom jazyku OCaml môžeme definovať rekurzívny variantový typ:
type nat = Zero | Succ of nat
Typ je rekurzívny, pretože sa nat nachádza aj v argumente konštruktora Succ.
Majme typ prirodzených čísel $Nat$. Hodnoty takéhoto typu reprezentujú buď nulu, alebo nasledovníka iného prirodzeného čísla. Pokúsme sa tento typ reprezentovať ako variantový typ: $$Nat=[zero:Unit, succ: ...].$$ Alternatíva $zero$ nesie iba hodnotu $unit$ typu $Unit$, pretože návestie už určuje nulu. Alternatíva $succ$ však nesie predchádzajúce prirodzené číslo: $$Nat=[zero:Unit, succ: Nat].$$ Takáto rovnica je rekurzívna špecifikácia, nie zavedenie obyčajnej typovej skratky: $Nat$ sa nachádza na oboch stranách. Môže poslúžiť ako špecifikácia nekonečného typového stromu:
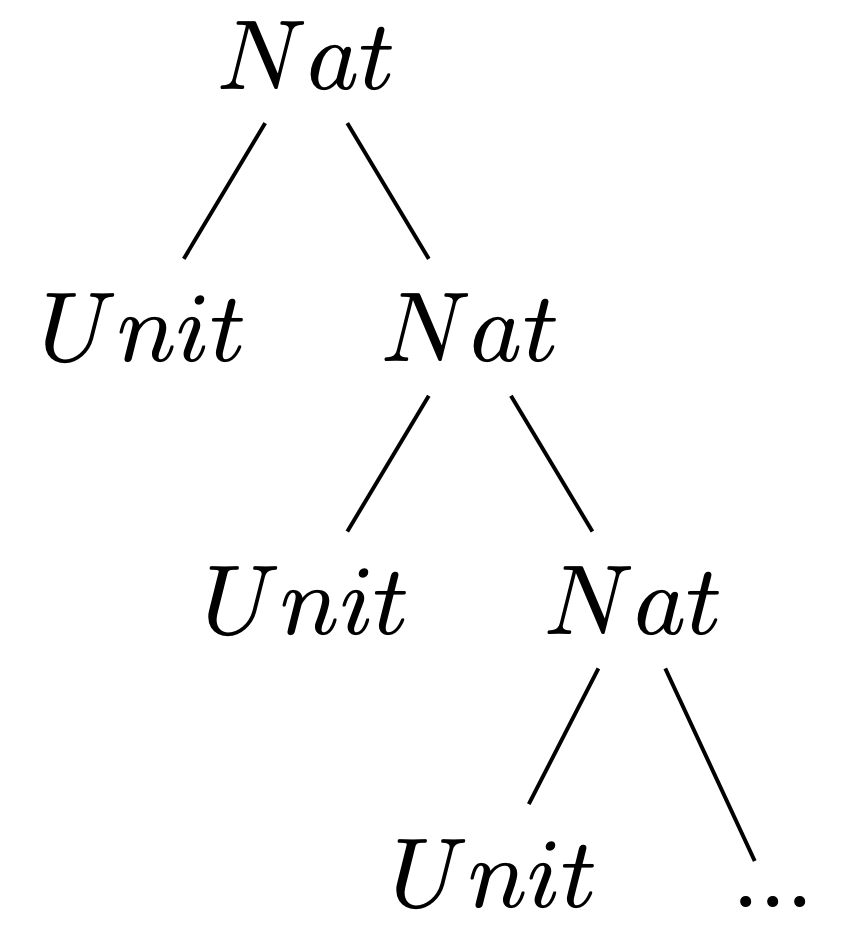
Inými slovami hľadáme riešenie rovnice rekurzívnej špecifikácie nekonečného stromu: $$X=[zero:Unit, succ: X].$$
Rekurzívnu špecifikáciu vyjadríme konečným zápisom s rekurzívnym operátorom $\mu$: $$Nat= \mu X. [zero:Unit, succ: X].$$ Zápis s $\mu$ je konečný typový výraz, ktorý zachytáva opakujúcu sa štruktúru špecifikácie $X=[zero:Unit,succ:X]$. Jeho vzťah k jednému rozbaleniu teraz spresníme.
Formalizácia rekurzívnych typov
Existujú dva základné spôsoby ako formalizovať rekurzívne typy:
- Ekvirekurzívne typy,
- Izorekurzívne typy.
Hlavným rozdielom je spôsob, akým je uvažované o relácii medzi typom $\mu X.T$ a jedným krokom jeho "rozbalenia": $$ \mu X.T \qquad \text{a} \qquad [X \mapsto \mu X.T]\ T $$
Pri type $Nat$ uvažujeme nad reláciou medzi: $$ Nat \qquad \text{ a } \qquad [zero:Unit, succ: Nat], $$ pričom po substitúcii $Nat$ definíciou vyššie získame: $$ \mu X. [zero:Unit, succ: X] \quad \text{ a } \quad [zero:Unit, succ: (\mu X. [zero:Unit, succ: X])] $$
- V ekvirekurzívnom prístupe je rekurzívny typ aj jeho rozbalený typ považovaný za ekvivalentný, keďže obidva opisujú ten istý nekonečný strom.
- Pri izorekurzívnom prístupe sú rekurzívne typy a ich rozbalené typy považované za rozdielne, avšak izomorfné typy.
Ekvirekurzívny prístup umožňuje používať rekurzívny typ a jeho rozbalenie zameniteľne. Typový systém preto potrebuje rovnosť typov, ktorá túto zameniteľnosť zohľadňuje; nejde iba o syntaktické porovnanie konečných výrazov.
Pri typovej kontrole treba rozhodovať rovnosť aj pri opakovanom rozbaľovaní. Pri obvyklých kontraktívnych rekurzívnych typoch možno pracovať s konečnou reprezentáciou pravidelných typových stromov; nepostačuje ich bez konca mechanicky rozpisovať. Kontraktívnosť tu znamená, že medzi viazaním $\mu X$ a rekurzívnym výskytom $X$ stojí typový konštruktor, ako v našich príkladoch variantu a súčtu; vylučuje napríklad $\mu X.X$.
Jednoduchá implementovateľnosť je silnou stránkou izorekurzívneho prístupu. Aj keď na formálnej úrovni potreba explicitného izomorfizmu medzi rekurzívnym typom a jeho rozbalením robí typový systém komplikovanejším, tento izomorfizmus je možné často úplne skryť za iné jazykové konštrukcie v implementácii. Z tohto dôvodu sa budeme ďalej podrobnejšie venovať tomuto prístupu.
Poznámka
Rekurzívne dátové typy rodiny ML, vrátane OCaml, môžeme vysvetliť izorekurzívnym modelom: konštruktor hodnotu zabalí a rozbor vzorov ju sprístupní. Konkrétny jazyk má vlastné pravidlá typovej rovnosti; toto porovnanie nie je tvrdením, že všetky jeho typy sú ekvirekurzívne alebo izorekurzívne.
Izorekurzívne typy
Pri tomto prístupe je výraz $$ \mu X.T $$ rekurzívny typ, pričom jeho rozbalený typ $$[X \mapsto \mu X.T]\ T$$ je rozdielny, avšak izomorfný typ.
Formálne je rozbalenie rekurzívneho typu $\mu X.T$ substitúcia všetkých voľných premenných $X$ v type $T$ celým rekurzívnym typom $\mu X.T$: $$\mu X.T \to [X \mapsto \mu X.T]\ T $$ Šípka v tomto zápise označuje metajazykový krok rozbalenia typovej štruktúry, nie operačnú redukciu termu. Odlišujeme ho od vyhodnocovania $t\to t'$ aj od termových operácií $fold$ a $unfold$. Napríklad rekurzívny typ prirodzených čísel $Nat$: $$\mu X. [zero:Unit, succ: X],$$ sa rozbalí na: $$[zero:Unit, succ: (\mu X. [zero:Unit, succ: X])].$$
V typovom systéme s izorekurzívnymi typmi zavedieme do jazyka pre každý typ $\mu X.T$ dvojicu termových konštrukcií, ktoré umožnia obojsmernú konverziu medzi rekurzívnym typom a jeho rozbalením: $$ \begin{array}{lcl} \mathbf{fold}_{\ \mu X.T} & : & [X \mapsto \mu X.T]\ T \to \mu X.T \\ \mathbf{unfold}_{\ \mu X.T} & : & \mu X.T \to [X \mapsto \mu X.T]\ T\\ \end{array} $$ Tieto konštrukcie opisujú prevody hodnôt medzi dvoma typmi. Ich úlohu vyššie zapisujeme funkčnými typmi, ale v gramatike nižšie ide o primitívne konštrukcie jazyka s jedným argumentom:
Poznámka
Dolný index pri konštrukciách fold a unfold môže byť vynechaný, ak je jasné o aký rekurzívny typ sa jedná.
Rozšírime syntax nášho jazyka nasledovne: $$ \begin{array}{lcl} t & ::= & \ldots\mid \mathsf{fold}_{\mu X.T}\ t\mid \mathsf{unfold}_{\mu X.T}\ t \\ v & ::= & \ldots\mid \mathsf{fold}_{\mu X.T}\ v\\ T & ::= & \ldots\mid X\mid \mu X.T \end{array} $$
Poznámka
Syntax pre hodnoty bola rozšírená len o operáciu fold, keďže hodnota rekurzívneho typu $\mu X.T$ môže vzniknúť len zabalením konkrétnej hodnoty.
Typovacie pravidlá:
Vyhodnocovacie pravidlá
Najprv sa vyhodnotí vnútorný term; rozbalenie sa vykoná až pri zabalenej hodnote. Pravidlo E-Unfold zachováva konštrukciu $unfold$ aj jej výsledný typ. Ak má $v$ typ $[X\mapsto\mu X.T]T$, potom $unfold_{\mu X.T}\;(fold_{\mu X.T}\ v)$ aj výsledok $v$ majú práve tento typ. Podobne E-Fold a E-Unfold prenášajú zachovanie typov z kroku $t\to t'$.
Na hodnotách sa prevody navzájom rušia: $unfold_{\mu X.T}\;(fold_{\mu X.T}\ v)\to v$. Opačná kompozícia nad hodnotou $fold_{\mu X.T}\ v$ vykoná krok v argumente vonkajšieho $fold$ a vráti tú istú zabalenú hodnotu.
Pokračujme príkladom zavedenia rekurzívneho typu prirodzených čísel $Nat$ izorekurzívnym prístupom:
$$Nat= \mu X. [zero:Unit, succ: X]$$
Je užitočné zaviesť skratku pre jeho rozbalený tvar:
$$Unnat=[zero:Unit, succ: (\underbrace{\mu X. [zero:Unit, succ: X])}_{Nat}]$$
Potom izomorfizmus medzi $Nat$ a $Unnat$ je zobrazený na nasledujúcom obrázku:
Pričom po substitúcii skratiek ich definíciami je možné vidieť zabalenie a rozbalenie rekurzívneho typu $Nat$:
Hodnotu nula a operáciu nasledovníka zavedieme s anotovanými variantmi z piatej prednášky:
$$ \begin{aligned} 0&=\mathsf{fold}_{Nat}\;([zero=\mathsf{unit}]\ \mathsf{as}\ [zero:\mathsf{Unit},succ:Nat]),\\ \mathsf{succ}&=\lambda n:Nat.\mathsf{fold}_{Nat}\;([succ=n]\ \mathsf{as}\ [zero:\mathsf{Unit},succ:Nat]). \end{aligned} $$
Platia typy $0:Nat$ a $succ:Nat\to Nat$. Anotácia $as\ [zero:Unit,succ:Nat]$ je súčasťou variantovej injekcie, nie dodatočným použitím T-Ascribe; $fold_{Nat}$ obaľuje celú injekciu.
Čísla definujeme ako zabalené hodnoty. Aplikácia $succ$ na predchádzajúcu hodnotu ich vytvorí jedným krokom:
$$ \begin{aligned} 1&=\mathsf{fold}_{Nat}\;([succ=0]\ \mathsf{as}\ [zero:\mathsf{Unit},succ:Nat]), &\mathsf{succ}\ 0\to1,\\ 2&=\mathsf{fold}_{Nat}\;([succ=1]\ \mathsf{as}\ [zero:\mathsf{Unit},succ:Nat]), &\mathsf{succ}\ 1\to2,\\ 3&=\mathsf{fold}_{Nat}\;([succ=2]\ \mathsf{as}\ [zero:\mathsf{Unit},succ:Nat]), &\mathsf{succ}\ 2\to3. \end{aligned} $$
Znak $=$ zavádza metajazykové skratky hodnôt, šípka označuje operačný krok po rozvinutí skratky $succ$. Nejde o pôvodné vstavané numerály.
Operácie $pred$ a $iszero$ nad touto reprezentáciou definujeme:
$$ \begin{aligned} \mathsf{pred}&=\lambda x:Nat.\mathsf{case}\ (\mathsf{unfold}_{Nat}\ x)\ \mathsf{of}\ [zero=x_1]\Rightarrow0\mid[succ=x_2]\Rightarrow x_2,\\ \mathsf{iszero}&=\lambda x:Nat.\mathsf{case}\ (\mathsf{unfold}_{Nat}\ x)\ \mathsf{of}\ [zero=x_1]\Rightarrow\mathsf{true}\mid[succ=x_2]\Rightarrow\mathsf{false}. \end{aligned} $$
Platia typy $pred:Nat\to Nat$ a $iszero:Nat\to Bool$. Pri rozbore má $x_1$ typ $Unit$ a $x_2$ typ $Nat$. Vo funkcii $pred$ majú obe vetvy typ $Nat$; vo funkcii $iszero$ majú obe vetvy typ $Bool$. V každej vetve je jej premenná viazaná iba v príslušnom tele. Preto je aj predchodcom nuly nula.
Rekurzívny typ $Nat$ definovaný ako binárny súčtový typ
Rekurzívny typ $Nat$ je možné definovať aj prostredníctvom binárneho súčtového typu. $$Nat \cong Unit + Nat,$$ to znamená, že je potrebné nájsť riešenie nasledujúcej rovnice: $$X=Unit + X.$$ Využitím rekurzívneho operátora $\mu$ definujeme typ $Nat$ nasledovne: $$Nat = \mu X.(Unit + X) $$ Definujeme skratku pre jeho rozbalenie: $$ Unnat = Unit + (\underbrace{\mu X. Unit + X}_{Nat})$$
Potom izomorfizmus medzi $Nat$ a $Unnat$ je zobrazený na nasledujúcom obrázku:
Pričom po substitúcii skratiek ich definíciami je možné vidieť zabalenie a rozbalenie rekurzívneho typu $Nat$:
Hodnotu nula a operáciu nasledovníka zadefinujeme pomocou anotovaných injekcií do binárneho súčtu:
$$ \begin{aligned} 0&=\mathsf{fold}_{Nat}\;(\mathsf{inl}\ \mathsf{unit}\ \mathsf{as}\ (\mathsf{Unit}+Nat)),\\ \mathsf{succ}&=\lambda n:Nat.\mathsf{fold}_{Nat}\;(\mathsf{inr}\ n\ \mathsf{as}\ (\mathsf{Unit}+Nat)). \end{aligned} $$
Tu $Nat$ označuje výhradne binárnu reprezentáciu $\mu X.(Unit+X)$. Anotácia injekcie zostáva vo vnútri $fold_{Nat}$ a určuje jej typ $Unit+Nat=Unnat$.
Ďalšie hodnoty definujeme rovnakým spôsobom ako pri variante:
$$ \begin{aligned} 1&=\mathsf{fold}_{Nat}\;(\mathsf{inr}\ 0\ \mathsf{as}\ (\mathsf{Unit}+Nat)), &\mathsf{succ}\ 0\to1,\\ 2&=\mathsf{fold}_{Nat}\;(\mathsf{inr}\ 1\ \mathsf{as}\ (\mathsf{Unit}+Nat)), &\mathsf{succ}\ 1\to2,\\ 3&=\mathsf{fold}_{Nat}\;(\mathsf{inr}\ 2\ \mathsf{as}\ (\mathsf{Unit}+Nat)), &\mathsf{succ}\ 2\to3. \end{aligned} $$
Operácie $pred$ a $iszero$ majú nasledujúce definície a typy:
$$ \begin{aligned} \mathsf{pred}&=\lambda x:Nat.\mathsf{case}\ (\mathsf{unfold}_{Nat}\ x)\ \mathsf{of}\ \mathsf{inl}\ x_1\Rightarrow0\mid\mathsf{inr}\ x_2\Rightarrow x_2,\\ \mathsf{iszero}&=\lambda x:Nat.\mathsf{case}\ (\mathsf{unfold}_{Nat}\ x)\ \mathsf{of}\ \mathsf{inl}\ x_1\Rightarrow\mathsf{true}\mid\mathsf{inr}\ x_2\Rightarrow\mathsf{false},\\ \mathsf{pred}&:Nat\to Nat,\\ \mathsf{iszero}&:Nat\to\mathsf{Bool}. \end{aligned} $$
V ľavej vetve je $x_1:Unit$, v pravej $x_2:Nat$. Vetvy $pred$ vracajú $Nat$, vetvy $iszero$ vracajú $Bool$. Nasledujúce stromy sa týkajú binárneho súčtu, preto používajú T-Inl, T-Inr a T-Case pre binárne injekcie.
Príklad
Overte, že hodnota nula má typ $Nat$. Po rozvinutí jej definície dostaneme úplný strom:
Posledný krok využíva rozbalenie $Nat\to Unit+Nat$. Anotovaná injekcia sa typuje priamo pravidlom T-Inl; samostatné T-Ascribe nepotrebujeme.
Príklad
Overte, že operácia nasledovníka má typ $Nat\to Nat$. Rozvinieme jej definíciu:
Príklad
Overte typ a vyhodnoťte $iszero\ 0$. Typový strom rozvinie definíciu funkcie aj nuly a obsahuje obe vetvy rozboru:
Vyhodnotenie. Najprv metajazykovou rovnosťou rozvinieme skratky $iszero$ a $0$. Potom vykonáme presne tri operačné kroky:
$$ \begin{aligned} &\mathsf{iszero}\ 0\\ ={}&(\lambda x:Nat.\mathsf{case}\ (\mathsf{unfold}_{Nat}\ x)\ \mathsf{of}\ \mathsf{inl}\ x_1\Rightarrow\mathsf{true}\mid\mathsf{inr}\ x_2\Rightarrow\mathsf{false})\;(\mathsf{fold}_{Nat}\;(\mathsf{inl}\ \mathsf{unit}\ \mathsf{as}\ (\mathsf{Unit}+Nat)))\\ \to{}&\mathsf{case}\ (\mathsf{unfold}_{Nat}\;(\mathsf{fold}_{Nat}\;(\mathsf{inl}\ \mathsf{unit}\ \mathsf{as}\ (\mathsf{Unit}+Nat))))\ \mathsf{of}\ \mathsf{inl}\ x_1\Rightarrow\mathsf{true}\mid\mathsf{inr}\ x_2\Rightarrow\mathsf{false}\\ \to{}&\mathsf{case}\ (\mathsf{inl}\ \mathsf{unit}\ \mathsf{as}\ (\mathsf{Unit}+Nat))\ \mathsf{of}\ \mathsf{inl}\ x_1\Rightarrow\mathsf{true}\mid\mathsf{inr}\ x_2\Rightarrow\mathsf{false}\\ \to{}&\mathsf{true}. \end{aligned} $$
Prvý krok je E-AppAbs so substitúciou hodnoty za $x$. Druhý používa E-UnfoldFold pod E-Case. Tretí vyberie ľavú vetvu podľa E-CaseInl: $[x_1\mapsto unit]true=true$. Anotácia injekcie sa zachová až do výberu vetvy a neodstraňuje sa osobitným krokom. Výsledok má typ $true:Bool$.
Implementácia izorekurzívnych typov v jazyku OCaml
Izorekurzívny prístup používa explicitné konštrukcie fold a unfold pri prechode medzi rekurzívnym typom a jeho rozbalením. V jazykoch s rekurzívnymi dátovými typmi môžu ich úlohu zastúpiť konštruktory a rozbor vzorov.
Príklad
Majme rekurzívny typ v OCaml:
type nat = Zero | Succ of nat
Správne typovaný výraz je napríklad:
Succ Zero
Konštruktor Succ očakáva argument typu nat; výraz Succ 5 preto nie je správne typovaný, keďže 5 má typ int. V našej formálnej interpretácii pomocou binárneho súčtu zodpovedá Zero hodnote $0$ a Succ Zero hodnote
$$\mathsf{fold}_{Nat}\;(\mathsf{inr}\ 0\ \mathsf{as}\ (\mathsf{Unit}+Nat)).$$
Podobne úplný rozbor vzorov v OCaml:
let iszero = function
  | Zero -> true
  | Succ x -> false

let pred = function
  | Zero -> Zero
  | Succ x -> x
zodpovedá rozbaleniu a rozboru oboch alternatív v našich formálnych definíciách. Platí iszero Zero = true, iszero (Succ Zero) = false a pred (Succ Zero) = Zero. Ide o vysvetlenie významu konštruktorov a rozboru vzorov, nie o tvrdenie, že prekladač OCaml doslovne generuje uvedené termy fold a unfold.
Zdroje
- Pierce, Benjamin C. Types and Programming Languages. MIT Press, 2002. Kapitoly o rekurzii, zoznamoch a rekurzívnych typoch.
- CS 4110: Lecture 27 — Recursive Types. Cornell University, jeseň 2012.
- Pfenning, Frank. 15-814: Lecture 10 — Recursive Types. Carnegie Mellon University, 30. september 2021.