Úvod
V tejto prednáške rozšírime jednoducho typovaný $\lambda$-kalkul z predchádzajúcej prednášky a formálne opíšeme nové konštrukcie.
- V úvode spresníme pojem základného typu a zavedieme jednotkový typ $\mathsf{Unit}$.
- Potom zavedieme odvodené tvary termov a ukážeme ich preklad do základného jazyka.
- V závere pridáme súčinové typy, ktoré umožnia pracovať s dvojicami, $n$-ticami a záznamami.
Zachováme stratégiu volania hodnotou (call by value): pred aplikáciou funkcie sa vyhodnotí jej argument a pod abstrakciami sa nevyhodnocuje. Pri nových zložených termoch určíme aj poradie vyhodnocovania ich zložiek. Zápis $t\to t'$ označuje jeden krok; $t\to^*t'$ označuje nula alebo viac krokov. Číslice $1,2,\ldots$ skracujú numerické hodnoty $\mathsf{succ}\ 0,\mathsf{succ}\;(\mathsf{succ}\ 0),\ldots$ nášho jazyka.
Typovacie úsudky majú tvar $\Gamma\vdash t:T$; pri prázdnom kontexte píšeme $\vdash t:T$. Ako v tretej prednáške, $t$ označuje ľubovoľný term, $v$ hodnotu a $nv$ numerickú hodnotu.
Základné typy, neinterpretované typy a jednoduché typy
V tretej prednáške sme jednoducho typovaný $\lambda$-kalkul ($\lambda_{\to}$, STLC) najprv definovali bez vstavaných údajových typov a potom doň zaviedli vstavané typy $\mathsf{Bool}$ a $\mathsf{Nat}$ spolu s ich hodnotami a operáciami. Budujeme vlastný jazyk; rovnaké typy a operácie sme už použili aj v pedagogickom jazyku NBL. Pripomeňme si rozlíšenie dvoch skupín atómových typov:
- Neinterpretované atómové typové konštanty tvoria neprázdnu množinu $\mathcal{A}=\{A,B,C,\ldots\}$. Sú to pevné syntaktické symboly, pre ktoré čistý STLC nezavádza vlastné hodnoty ani primitívne operácie.
- Vstavané základné typy tvoria množinu $\mathcal{B}$. Jazyk pre ne určuje hodnoty, prípadné primitívne operácie a pravidlá typovania a vyhodnocovania. V čistom STLC platí $\mathcal{B}=\emptyset$; po zavedení booleovských hodnôt a prirodzených čísel máme $\mathcal{B}=\{\mathsf{Bool},\mathsf{Nat}\}$.
Atómové typy nemajú vnútornú typovú štruktúru. Funkčné typy z nich vznikajú použitím konštruktora $\to$. Naďalej používame všeobecnú gramatiku jednoduchých typov:
$$ T::=a\mid b\mid T\to T, \qquad a\in\mathcal{A},\quad b\in\mathcal{B}. $$
Symboly $A,B,C$ označujú konkrétne typové konštanty. Metapremenné $a$ a $b$ zastupujú prvky $\mathcal{A}$ a $\mathcal{B}$; $T,S,R$ a ich indexované varianty zastupujú ľubovoľné jednoduché typy. Napríklad $A$, $\mathsf{Nat}$, $A\to\mathsf{Bool}$ aj $(\mathsf{Nat}\to A)\to\mathsf{Nat}$ sú jednoduché typy. „Jednoduchý“ teda neznamená iba „základný“.
Ďalšie vstavané typy, napríklad $\mathsf{Int}$, $\mathsf{Float}$, $\mathsf{Char}$ či $\mathsf{String}$, by sme pridali do $\mathcal{B}$ spolu s ich hodnotami a pravidlami. Zatiaľ nie sú súčasťou definovaného jazyka. V nasledujúcej časti pridáme jednotkový typ $\mathsf{Unit}$.
Poznámka
Pre pevné $A\in\mathcal{A}$ platí $\vdash\lambda x:A.x:A\to A$. Opakovanie tejto konštrukcie pre rôzne voľby $A$ je metajazyková schéma, nie jeden polymorfný term. STLC neobsahuje typovú abstrakciu ani univerzálnu kvantifikáciu nad typmi; tie zavedie až neskorší systém F.
Jednotkový typ
Funkcia môže vykonať užitočnú činnosť bez toho, aby vracala ďalší údaj. Pri výpise nás zaujíma zobrazený text; výsledná hodnota iba oznamuje dokončenie volania.
Príklad
V jazyku OCaml môžeme definovať funkciu, ktorá vypíše pozdrav:
# let pozdrav meno = print_endline ("Ahoj, " ^ meno ^ "!");;
val pozdrav : string -> unit = <fun>
# pozdrav "OCaml";;
Ahoj, OCaml!
- : unit = ()
Výpis je vedľajší účinok (side effect). Výsledkom volania je hodnota (), jediná hodnota typu unit v OCamli.
Jazyk $\lambda_{\to}$ rozšírime o jednotkový typ (unit type) $\mathsf{Unit}$ s jedinou hodnotou $\mathsf{unit}$. Ide o najjednoduchší interpretovaný základný typ. Všeobecný názov singleton označuje typ alebo množinu s jediným prvkom.
Typ $\mathsf{Unit}$ má jedinú hodnotu, ale viacero termov: napríklad $(\lambda x:\mathsf{Unit}.x)\;\mathsf{unit}$ ešte potrebuje krok vyhodnotenia. Ak sa uzavretý správne typovaný term typu $\mathsf{Unit}$ vyhodnotí na hodnotu, touto hodnotou je $\mathsf{unit}$. Pri otvorenom terme, napríklad samotnej premennej $x$ v kontexte $x:\mathsf{Unit}$, nemusí byť možné vykonať krok bez dodania hodnoty za $x$.
Zavedením $\mathsf{Unit}$ rozšírime množinu vstavaných základných typov:
$$\mathcal{B}=\{\mathsf{Bool},\mathsf{Nat},\mathsf{Unit}\}.$$
Množina $\mathcal{A}$ zostáva nezmenená. Všeobecná gramatika jednoduchých typov má naďalej tvar
$$ T::=a\mid b\mid T\to T, \qquad a\in\mathcal{A},\quad b\in\mathcal{B}. $$
Mení sa iba obsah $\mathcal{B}$, teda typy, ktoré môže zastupovať metapremenná $b$.
Syntax termov a hodnôt rozšírime nasledovne: $$ \begin{array}{ll} t::= & \ldots\mid\mathsf{unit} \\ v::= & \ldots\mid\mathsf{unit} \end{array} $$
Pridáme nové typovacie pravidlo: $$ \frac{}{\Gamma\vdash\mathsf{unit}:\mathsf{Unit}}\quad{\small(\text{T-Unit})} $$
Konštanta $\mathsf{unit}$ je už hodnotou, preto pre ňu nepridávame vyhodnocovacie pravidlo. Samotné pridanie typu $\mathsf{Unit}$ nepridáva do formálneho kalkulu výpis ani iné vedľajšie účinky; tie zatiaľ iba motivujú jeho použitie.
Poznámka
Jednotkový typ využijeme pri odvodených tvaroch termov, neskôr aj pri enumeračných a referenčných typoch.
Odvodené tvary termov
Odvodený tvar (derived form) je pohodlnejší zápis, ktorý možno preložiť do základných konštrukcií jazyka. Uľahčuje písanie a čítanie programov bez potreby pridávať nový výpočtový mechanizmus do jadra.
Zavedieme štyri odvodené tvary:
- zoradenie (sequencing);
- zastúpenie nepoužitého parametra (wildcard);
- pripísanie typu (ascription);
- väzbu let (let binding).
Pri každom tvare vysvetlíme jeho význam aj vzťah k abstrakcii a aplikácii. Najprv ho môžeme opísať vlastnou syntaxou a pravidlami; potom overíme, že jeho správanie vieme vyjadriť v jadrovom jazyku.
Zoradenie (sequencing)
V jazykoch s vedľajšími účinkami je užitočné vykonať viac výpočtov za sebou, napríklad najprv vypísať text a potom pokračovať ďalším výpočtom. Zápis
$$t_1;t_2$$
znamená:
- najprv sa vyhodnotí $t_1$;
- jeho výsledná hodnota sa nepoužije;
- následne sa vyhodnotí $t_2$, ktorého hodnota je výsledkom celého zoradenia.
V našom typovom systéme vyžadujeme $\Gamma\vdash t_1:\mathsf{Unit}$, takže pri ukončení prvého výpočtu je jeho výsledkom $\mathsf{unit}$. Zoradenie teda určuje postupné vyhodnotenie aj vtedy, keď druhý term nepotrebuje výsledok prvého.
Existujú dva spôsoby formalizácie zoradenia.
1. Samostatná syntaktická konštrukcia. Rozšírime syntax o nový tvar:
$$t::=\ldots\mid t_1;t_2.$$
Pridáme vyhodnocovacie pravidlá:
$$ \frac{t_1\to t_1'}{t_1;t_2\to t_1';t_2}\quad{\small(\text{E-Seq})} $$
$$ \frac{}{\mathsf{unit};t_2\to t_2}\quad{\small(\text{E-SeqNext})} $$
Pravidlo E-Seq vyhodnocuje prvý term. Až E-SeqNext odstráni jeho výsledok $\mathsf{unit}$ a sprístupní druhý term na vyhodnocovanie.
Typovacie pravidlo vyžaduje jednotkový typ prvého termu a prenáša typ druhého termu na celé zoradenie:
$$ \frac{\Gamma\vdash t_1:\mathsf{Unit}\qquad\Gamma\vdash t_2:T_2} {\Gamma\vdash t_1;t_2:T_2}\quad{\small(\text{T-Seq})} $$
2. Odvodený tvar. Zápis $t_1;t_2$ chápeme ako skratku:
$$t_1;t_2\ \overset{\mathrm{def}}=\ (\lambda x:\mathsf{Unit}.t_2)\;t_1,$$
kde $x$ zvolíme čerstvé, najmä $x\notin FV(t_2)$, aby nevzniklo zachytenie voľnej premennej. Parameter sa v tele nepoužíva. Pri volaní hodnotou sa najprv vyhodnotí argument $t_1$; aplikácia potom pokračuje telom $t_2$.
Príklad
OCaml podporuje vedľajšie účinky, preto nepatrí medzi čisté funkcionálne jazyky. Jeho funkcie print_string a print_newline vykonajú výpis a vrátia ():
# print_string;;
- : string -> unit = <fun>
# print_newline;;
- : unit -> unit = <fun>
Zoradenie umožňuje spojiť výpis s ďalším výpočtom:
# print_string "Hello, ";
  print_string "world!";
  print_newline ();
  succ 4;;
Hello, world!
- : int = 5
Prvé tri výrazy majú typ unit. Typ a hodnotu celej postupnosti určuje posledný výraz succ 4.
Poznámka
V čistom funkcionálnom jazyku Haskell sa vstup a výstup opisujú akciami typu IO. Ich skladanie používa monadické operácie; čistý výraz sám nevykonáva ľubovoľné vedľajšie účinky.
Interný a externý jazyk
Pri preklade programu rozlišujeme:
- Externý jazyk $\lambda_{\to}^E$: povrchový jazyk, v ktorom programátor zapisuje termy. Tu obsahuje STLC so vstavanými typmi $\mathsf{Bool}$, $\mathsf{Nat}$ a $\mathsf{Unit}$, ich hodnotami a operáciami a so zoradením.
- Interný jazyk $\lambda_{\to}^I$: jadrový jazyk, do ktorého sa program preloží. Obsahuje rovnaké základné konštrukcie a typy, ale nemá zoradenie.
Elaborácia (elaboration) je preklad z externého do interného jazyka, pri ktorom sa môžu dopĺňať aj informácie potrebné pre jadrový zápis.
Príklad
Term $((\lambda u:\mathsf{Unit}.u)\;\mathsf{unit});0$ sa preloží na $(\lambda x:\mathsf{Unit}.0)\;((\lambda u:\mathsf{Unit}.u)\;\mathsf{unit})$. Premenná $x$ sa v tele nevyskytuje.
V externom jazyku prebehne výpočet:
$$ ((\lambda u:\mathsf{Unit}.u)\;\mathsf{unit});0 \to_E\mathsf{unit};0\to_E0. $$
V internom jazyku mu zodpovedá:
$$ \begin{aligned} &(\lambda x:\mathsf{Unit}.0)\;((\lambda u:\mathsf{Unit}.u)\;\mathsf{unit})\\ &\to_I(\lambda x:\mathsf{Unit}.0)\;\mathsf{unit}\\ &\to_I0. \end{aligned} $$
Najprv sa vyhodnotí argument a až potom sa vykoná aplikácia. Výsledok prvého termu sa pri dosadení nepoužije.
Veta o zoradení
Nech $e:\lambda_{\to}^E\to\lambda_{\to}^I$ je elaboračná funkcia definovaná predpisom
$$e(t_1;t_2)=(\lambda x:\mathsf{Unit}.e(t_2))\;e(t_1).$$
Na ostatných konštrukciách $e$ zachováva konštruktor a rekurzívne prekladá podtermy; typové anotácie nemení. Nové viazané mená volíme čerstvé. Termy porovnávame až na $\alpha$-ekvivalenciu.
Veta. Pre ľubovoľný platný kontext $\Gamma$, term $t$ externého jazyka a typ $T$ platí zachovanie aj odraz typovania:
$$\Gamma\vdash_Et:T\quad\Longleftrightarrow\quad\Gamma\vdash_Ie(t):T.$$
Ak je $t$ správne typovaný v externom jazyku, platia aj tieto dve tvrdenia o vyhodnocovaní:
- Ak $t\to_Et'$, potom $e(t)\to_Ie(t')$.
- Ak $e(t)\to_Iu$, potom existuje externý term $t'$ taký, že $t\to_Et'$ a $u=_\alpha e(t')$.
Každému externému kroku teda zodpovedá jeden interný krok a každý krok preloženého správne typovaného termu možno priradiť externému kroku. Podmienka typovateľnosti je podstatná: napríklad netypovateľný term $\mathsf{true};0$ je zaseknutý, ale jeho preklad $(\lambda x:\mathsf{Unit}.0)\;\mathsf{true}$ vykoná krok na $0$.
Opačný smer formulujeme pomocou existencie $t'$, pretože elaborácia nie je injektívna: zoradenie a jeho už rozvinutý zápis môžu mať rovnaký preklad. Nemožno preto z ľubovoľne vybraného $e(t')$ jednoznačne spätne určiť syntaktický tvar externého výsledku.
Dôkaz
Tvrdenia overíme indukciou podľa príslušných odvodení. Typovanie zoradenia sa preloží pomocou T-Abs a T-App. Pravidlu E-Seq zodpovedá E-App2 a pravidlu E-SeqNext krok E-AppAbs. Pri opačnom smere zaručuje typovanie, že hodnota v prvej zložke zoradenia musí byť $\mathsf{unit}$. V prípade aplikácie využijeme aj to, že preklad rešpektuje substitúciu bez zachytenia.
Syntaktický cukor a jeho rozvinutie
Odvodené tvary sa nazývajú aj syntaktický cukor (syntactic sugar), pretože zvyšujú pohodlie zápisu. Ich rozvinutie do základných konštrukcií sa nazýva desugaring. Pri zoradení naň stačí syntax a výber čerstvého mena.
Elaborácia je širší pojem: okrem rozvinutia skratiek môže napríklad dopĺňať typové anotácie. Typová kontrola naproti tomu rozhoduje, či term spĺňa požadované typovacie pravidlá. Implementácia môže tieto činnosti prepájať, ale ide o odlišné úlohy.
Desugaring nemusí prebiehať priamo v parseri. Jednoduché skratky možno rozvinúť po syntaktickej analýze; pri väzbe let neskôr ukážeme preklad využívajúci aj odvodený typ. Zachovanie typov a správania treba pre konkrétny preklad overiť, ako sme to urobili pri zoradení.
Zastúpenie nepoužitého parametra (wildcard)
Niekedy potrebujeme abstrakciu, ktorej parameter sa v tele nepoužíva. Taká funkcia je vzhľadom na tento parameter konštantná. Namiesto zbytočného mena parametra zapíšeme podčiarkovník:
$$\lambda\_:S.t.$$
Ide o skratku za $\lambda x:S.t$, kde $x$ je čerstvé, najmä $x\notin FV(t)$. Podčiarkovník teda nezavádza premennú dostupnú v tele. Typ $S$ uvádzame aj pri nepoužitom parametri, aby sme mohli skontrolovať typ argumentu aplikácie.
Ak tento zápis ponecháme v externom jazyku ako samostatný tvar, pridáme ho aj medzi hodnoty:
$$t::=\ldots\mid\lambda\_:S.t,\qquad v::=\ldots\mid\lambda\_:S.t.$$
Typovacie pravidlo nepotrebuje rozšíriť kontext o deklaráciu parametra:
$$ \frac{\Gamma\vdash t:T} {\Gamma\vdash\lambda\_:S.t:S\to T}\quad{\small(\text{T-Wildcard})} $$
Vyhodnocovacie pravidlo odstráni argument až po jeho vyhodnotení na hodnotu:
$$ \frac{}{(\lambda\_:S.t)\;v\to t}\quad{\small(\text{E-Wildcard})} $$
Vyhodnocovanie funkčnej časti a argumentu naďalej riadia pôvodné pravidlá aplikácie. Aj ignorovaný argument sa pri volaní hodnotou musí najprv vyhodnotiť.
Príklad
V OCamli je _ na mieste parametra zástupný vzor (wildcard pattern):
# let kons1 _ = 4;;
val kons1 : 'a -> int = <fun>
# let kons2 (_ : int) = 4;;
val kons2 : int -> int = <fun>
Obe funkcie ignorujú argument a vracajú 4. Funkcia kons1 nemá obmedzenie na typ argumentu; OCaml jej priradí polymorfný typ. Pri kons2 anotácia (_ : int) určuje typ parametra, preto prijíma iba int.
Anotácia výsledku má iné umiestnenie: let kons3 _ : int = 4;; určuje typ výsledku, nie argumentu. Podčiarkovník na mieste typu, napríklad (x : _), zase ponecháva typ na odvodenie a sám neoznačuje nepoužitý parameter. Polymorfné typy OCaml tu iba pozorujeme; formálny systém tejto prednášky zostáva jednoducho typovaný.
Pripísanie typu (ascription)
Pripísanie typu umožňuje explicitne uviesť, aký typ má mať daný term. Napríklad $(\mathsf{pred}\ 4)\ \mathsf{as}\ \mathsf{Nat}$ vyjadruje požiadavku, aby term $\mathsf{pred}\ 4$ mal typ $\mathsf{Nat}$. Nejde o konverziu hodnoty na iný typ.
Syntax rozšírime o nový tvar:
$$t::=\ldots\mid t\ \mathsf{as}\ T.$$
Typovacie pravidlo kontroluje zhodu uvedeného a odvodeného typu:
$$ \frac{\Gamma\vdash t:T} {\Gamma\vdash t\ \mathsf{as}\ T:T}\quad{\small(\text{T-Ascribe})} $$
Vyhodnocovacie pravidlá najprv vyhodnotia term a potom odstránia pripísanie:
$$ \frac{}{v\ \mathsf{as}\ T\to v}\quad{\small(\text{E-Ascribe})} $$
$$ \frac{t\to t'} {t\ \mathsf{as}\ T\to t'\ \mathsf{as}\ T}\quad{\small(\text{E-Ascribe1})} $$
Príklad
Pripísanie prirodzeného typu sa vyhodnotí takto:
$$(\mathsf{pred}\ 4)\ \mathsf{as}\ \mathsf{Nat}\to3\ \mathsf{as}\ \mathsf{Nat}\to3.$$
Pripísanie nie je hodnotou ani vtedy, keď je jeho podterm už hodnotou. Preto je potrebný aj druhý krok, ktorý odstráni $\mathsf{as}\ \mathsf{Nat}$.
Anotácia môže byť dôležitá pri statickej kontrole, hoci vo výslednej hodnote nezostane. Elaborácia môže po overení typu odstrániť zápis $\mathsf{as}\ T$ a ponechať preklad termu $t$. Krok odstránenia pripísania vtedy nemá vlastný krok v jadre; presná zhoda po jednom kroku z vety o zoradení sa preto automaticky neprenáša na všetky odvodené tvary.
Poznámka
Pripísanie zvyšuje čitateľnosť a dokumentuje očakávaný typ podtermu. V ďalšej prednáške ho využijeme pri súčtových typoch: hodnota vložená do jednej vetvy sama neurčuje typ druhej vetvy, takže anotácia poskytne chýbajúcu statickú informáciu.
Väzba let (let binding)
Väzba let pomenuje výsledok podvýpočtu a umožňuje toto meno používať v ďalšom terme. Znižuje opakovanie zápisu a zvyšuje čitateľnosť. V našom jazyku zápis
$$\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2$$
najprv vyhodnotí $t_1$ na hodnotu $v_1$ a potom pokračuje telom $t_2$, v ktorom za voľné výskyty $x$ dosadí $v_1$. Rozsah väzby $x$ je iba $t_2$, nie $t_1$; táto konštrukcia teda sama nezavádza rekurziu.
Príklad
Uvažujme term $\mathsf{let}\ x=\mathsf{succ}\ 2\ \mathsf{in}\ \mathsf{succ}\ x$. Term $\mathsf{succ}\ 2$ je už numerickou hodnotou $3$: v našom jazyku sa nasledovník numerickej hodnoty ďalej neredukuje. Preto ako prvý skutočný vyhodnocovací krok vykonáme substitúciu:
$$ \begin{aligned} &\mathsf{let}\ x=\mathsf{succ}\ 2\ \mathsf{in}\ \mathsf{succ}\ x\\ &\to[x\mapsto\mathsf{succ}\ 2](\mathsf{succ}\ x)\\ &=\mathsf{succ}\;(\mathsf{succ}\ 2)=4. \end{aligned} $$
Rovnosti tu iba rozpisujú substitúciu a číselnú skratku. Na odlíšenie vyhodnocovania viazaného termu od substitúcie použime aj variant, ktorý obsahuje skutočný podkrok:
$$ \begin{aligned} &\mathsf{let}\ x=\mathsf{pred}\ 4\ \mathsf{in}\ \mathsf{pred}\ x\\ &\to\mathsf{let}\ x=3\ \mathsf{in}\ \mathsf{pred}\ x\\ &\to[x\mapsto3](\mathsf{pred}\ x)\\ &=\mathsf{pred}\ 3\to2. \end{aligned} $$
Najprv vypočítame viazaný term, potom dosadíme jeho hodnotu za $x$ a nakoniec vyhodnotíme výsledné telo. Zodpovedajúca aplikácia abstrakcie má rovnaký priebeh:
$$(\lambda x:\mathsf{Nat}.\mathsf{pred}\ x)\;(\mathsf{pred}\ 4) \to(\lambda x:\mathsf{Nat}.\mathsf{pred}\ x)\;3 \to\mathsf{pred}\ 3\to2.$$
Syntax rozšírime o nový tvar:
$$t::=\ldots\mid\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2.$$
Typovacie pravidlo najprv určí typ $T_1$ viazaného termu a pri typovaní tela rozšíri kontext o $x:T_1$:
$$ \frac{\Gamma\vdash t_1:T_1\qquad\Gamma,x:T_1\vdash t_2:T_2} {\Gamma\vdash\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2:T_2} \quad{\small(\text{T-Let})} $$
Predpokladáme platný rozšírený kontext $\Gamma,x:T_1$; prípadnú kolíziu viazaného mena odstránime $\alpha$-premenovaním.
Pridáme dve vyhodnocovacie pravidlá:
$$ \frac{t_1\to t_1'} {\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2\to\mathsf{let}\ x=t_1'\ \mathsf{in}\ t_2} \quad{\small(\text{E-Let})} $$
$$ \frac{}{\mathsf{let}\ x=v_1\ \mathsf{in}\ t_2\to[x\mapsto v_1]t_2} \quad{\small(\text{E-LetV})} $$
Pravidlo E-Let vyhodnocuje $t_1$. Pravidlo E-LetV vykoná substitúciu bez zachytenia $[x\mapsto v_1]t_2$: hodnotu $v_1$ dosadí do tela $t_2$ za voľné výskyty premennej $x$.
Ak má byť let odvodeným tvarom, musíme ho preložiť do interného jazyka. Ak $\Gamma\vdash t_1:T_1$, použijeme rozvinutie
$$\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2\ \overset{\mathrm{def}}=\ (\lambda x:T_1.t_2)\;t_1.$$
Ak podtermy obsahujú ďalšie odvodené tvary, preložíme aj tie. V externom zápise nie je $T_1$ explicitne uvedený, ale interná abstrakcia ho potrebuje ako anotáciu parametra. Samotná syntaktická analýza preto v tomto prístupe neposkytuje všetky potrebné informácie.
Zvolíme typovo riadenú elaboráciu: pri odvodení typu $t_1$ získame $T_1$, v kontexte $\Gamma,x:T_1$ skontrolujeme telo a vytvoríme anotovanú abstrakciu s aplikáciou. Typová analýza a tvorba interného termu tu spolupracujú. Nie je to jediný možný spôsob implementácie let; napríklad jadrový jazyk by mohol obsahovať vlastnú konštrukciu let.
Typovací strom externého termu má tvar:
$$ \dfrac{\dfrac{\vdots}{\Gamma\vdash t_1:T_1}\qquad \dfrac{\vdots}{\Gamma,x:T_1\vdash t_2:T_2}} {\Gamma\vdash\mathsf{let}\ x=t_1\ \mathsf{in}\ t_2:T_2} \quad{\small(\text{T-Let})} $$
Z tých istých odvodení podtermov zostrojíme strom v internom jazyku pomocou T-Abs a T-App:
$$ \dfrac{\dfrac{\dfrac{\vdots}{\Gamma,x:T_1\vdash t_2:T_2}} {\Gamma\vdash\lambda x:T_1.t_2:T_1\to T_2}\;{\small(\text{T-Abs})} \qquad\dfrac{\vdots}{\Gamma\vdash t_1:T_1}} {\Gamma\vdash(\lambda x:T_1.t_2)\;t_1:T_2} \quad{\small(\text{T-App})} $$
Poznámka
Väzba let v OCamli má dôležitú úlohu aj pri let polymorfizme, ktorému sa budeme venovať neskôr. Tu zavedené pravidlo T-Let prideľuje $x$ jeden konkrétny typ $T_1$ a polymorfnú generalizáciu neobsahuje.
Súčinové typy
Väčšina programovacích jazykov umožňuje spájať údaje do zložených štruktúr. V našom jazyku na to použijeme súčinové typy (product types):
- Dvojica (pair) obsahuje dve zložky, ktoré môžu mať rôzne typy.
- N-tica (tuple) zovšeobecňuje dvojicu na konečný počet zložiek.
- Záznam (record) pomenúva jednotlivé položky návestiami.
Typový konštruktor binárneho súčinu označíme symbolom $\times$. Z typov $T_1$ a $T_2$ vytvára nový jednoduchý typ $T_1\times T_2$. Nepridávame atómový prvok do $\mathcal{B}$, ale rozširujeme gramatiku typov o nový konštruktor:
$$ T::=a\mid b\mid T\to T\mid T\times T, \qquad a\in\mathcal{A},\quad b\in\mathcal{B}. $$
Množiny $\mathcal{A}$ a $\mathcal{B}=\{\mathsf{Bool},\mathsf{Nat},\mathsf{Unit}\}$ zostávajú nezmenené. Súčasne pridáme konštruktory dvojíc a ich projekcie.
Dvojica
Binárny súčin typov $T_1,T_2$ zapisujeme $T_1\times T_2$. Konštruktor dvojice má tvar
$$\langle t_1,t_2\rangle,$$
kde $\Gamma\vdash t_1:T_1$ a $\Gamma\vdash t_2:T_2$. Výsledný term má typ $T_1\times T_2$. Čiarka oddeľuje termy, kým symbol $\times$ spája typy.
Nie každý term súčinového typu musí byť syntakticky dvojicou: môže ním byť aj premenná alebo aplikácia funkcie, ktorá dvojicu vráti. Dvojica je hodnotou až vtedy, keď sú hodnotami obe jej zložky.
Príklad
Nasledujúce uzavreté termy majú súčinové typy. Typovacie úsudky uvádzame v prázdnom kontexte:
$$ \begin{aligned} \vdash\langle1,4\rangle&:\mathsf{Nat}\times\mathsf{Nat},\\ \vdash\langle\mathsf{true},0\rangle&:\mathsf{Bool}\times\mathsf{Nat},\\ \vdash\langle\mathsf{iszero}\ 0,4\rangle&:\mathsf{Bool}\times\mathsf{Nat},\\ \vdash\langle\mathsf{false},\mathsf{if}\ \mathsf{iszero}\ 0\ \mathsf{then}\ \mathsf{true}\ \mathsf{else}\ \mathsf{false}\rangle &:\mathsf{Bool}\times\mathsf{Bool},\\ \vdash\langle\langle1,2\rangle,\mathsf{true}\rangle&:(\mathsf{Nat}\times\mathsf{Nat})\times\mathsf{Bool}. \end{aligned} $$
Tretí term ešte nie je hodnotou: jeho prvá zložka sa musí vyhodnotiť. Jej typ je $\mathsf{Bool}$, pretože $\mathsf{iszero}$ vracia booleovský výsledok.
Zložky dvojice získame pomocou projekcií (projections):
- Prvá projekcia $t.1$ vyberá prvú zložku.
- Druhá projekcia $t.2$ vyberá druhú zložku.
Ide o dva primitívne eliminátory dvojice v našom jazyku. Ďalšie funkcie nad dvojicami môžeme zostavovať pomocou týchto projekcií, abstrakcie a aplikácie.
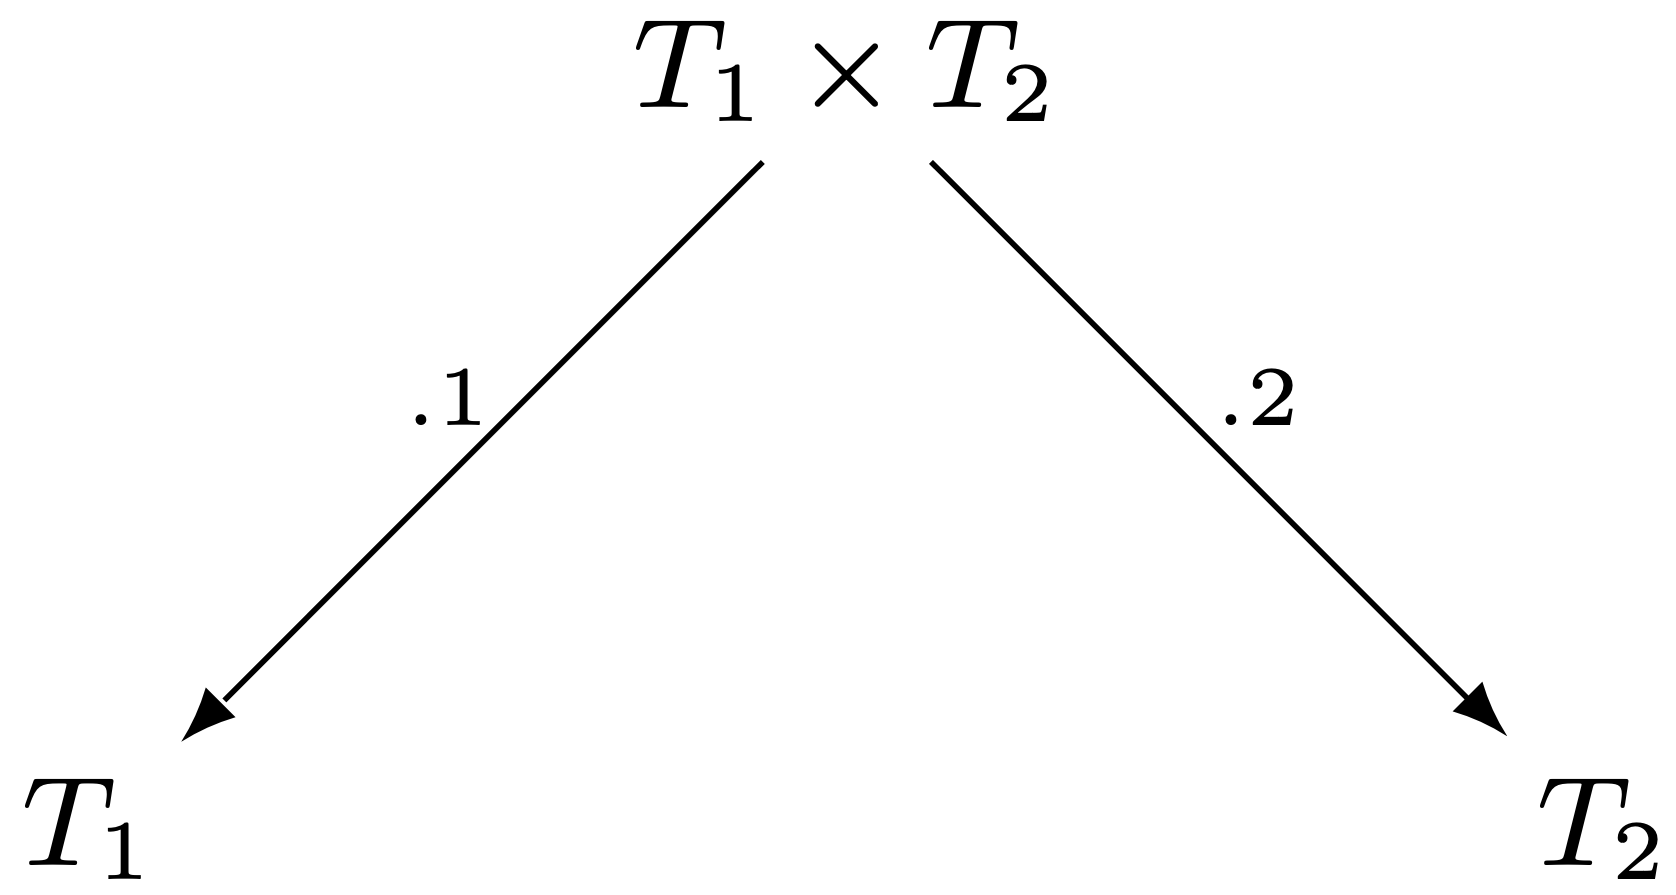
Syntax rozšírime o dvojice, projekcie a súčinový typ:
$$ \begin{array}{ll} t::=&\ldots\mid\langle t,t\rangle\mid t.1\mid t.2,\\ v::=&\ldots\mid\langle v,v\rangle,\\ T::=&\ldots\mid T\times T. \end{array} $$
Projekcia sa viaže tesnejšie než aplikácia: $f\ t.1$ čítame ako $f\;(t.1)$. Projekciu výsledku aplikácie zapisujeme $(f\ t).1$.
Typovacie pravidlá:
$$ \frac{\Gamma\vdash t_1:T_1\qquad\Gamma\vdash t_2:T_2} {\Gamma\vdash\langle t_1,t_2\rangle:T_1\times T_2} \quad{\small(\text{T-Pair})} $$
$$ \frac{\Gamma\vdash t:T_1\times T_2}{\Gamma\vdash t.1:T_1} \quad{\small(\text{T-Proj1})} $$
$$ \frac{\Gamma\vdash t:T_1\times T_2}{\Gamma\vdash t.2:T_2} \quad{\small(\text{T-Proj2})} $$
T-Pair vytvorí súčinový typ z typov oboch zložiek. T-Proj1 a T-Proj2 vyberú príslušný typ; typovanie projekcie nevyžaduje, aby bol term už hodnotou.
Vyhodnocovacie pravidlá:
$$ \frac{}{\langle v_1,v_2\rangle.1\to v_1}\quad{\small(\text{E-BetaPair1})} $$
$$ \frac{}{\langle v_1,v_2\rangle.2\to v_2}\quad{\small(\text{E-BetaPair2})} $$
$$ \frac{t\to t'}{t.1\to t'.1}\quad{\small(\text{E-Proj1})} $$
$$ \frac{t\to t'}{t.2\to t'.2}\quad{\small(\text{E-Proj2})} $$
$$ \frac{t_1\to t_1'}{\langle t_1,t_2\rangle\to\langle t_1',t_2\rangle} \quad{\small(\text{E-Pair1})} $$
$$ \frac{t_2\to t_2'}{\langle v_1,t_2\rangle\to\langle v_1,t_2'\rangle} \quad{\small(\text{E-Pair2})} $$
E-Pair1 najprv vyhodnocuje prvú zložku. E-Pair2 môže vyhodnocovať druhú až vtedy, keď je prvá hodnotou. E-Proj1 a E-Proj2 prenášajú kroky dvojice pod projekciu; E-BetaPair1 a E-BetaPair2 potom vyberú zložku z hotovej dvojice hodnôt.
Poznámka
Používame volanie hodnotou s poradím zľava doprava. Pred projekciou vyhodnotíme obe zložky, aj keď jednu z nich výsledok projekcie nepoužije. Toto poradie je súčasťou zvolenej operačnej sémantiky.
Príklad
Vyhodnoťme term
$$\langle\mathsf{pred}\ 4,\mathsf{if}\ \mathsf{true}\ \mathsf{then}\ \mathsf{false}\ \mathsf{else}\ \mathsf{false}\rangle.1.$$
Pri každom kroku uvedieme pravidlo pre celý term:
$$ \begin{aligned} &\langle\mathsf{pred}\ 4,\mathsf{if}\ \mathsf{true}\ \mathsf{then}\ \mathsf{false}\ \mathsf{else}\ \mathsf{false}\rangle.1\\ &\to\langle3,\mathsf{if}\ \mathsf{true}\ \mathsf{then}\ \mathsf{false}\ \mathsf{else}\ \mathsf{false}\rangle.1 &&{\small(\text{E-Proj1})}\\ &\to\langle3,\mathsf{false}\rangle.1 &&{\small(\text{E-Proj1})}\\ &\to3 &&{\small(\text{E-BetaPair1})}. \end{aligned} $$
Premisou prvého kroku E-Proj1 je krok dvojice podľa E-Pair1, ktorý využije $\mathsf{pred}\ 4\to3$ (E-PredSucc). V druhom kroku je premisou E-Pair2 s podkrokom podmieneného výrazu podľa E-IfTrue. Až tretí krok vykoná projekciu. Zvolená sémantika určuje túto postupnosť jednoznačne.
Príklad
Vyhodnoťme aplikáciu funkcie na dvojicu:
$$(\lambda x:\mathsf{Nat}\times\mathsf{Nat}.x.2)\;\langle\mathsf{pred}\ 4,\mathsf{pred}\ 5\rangle.$$
Abstrakcia je už hodnotou, ale argument sa musí najprv vyhodnotiť:
$$ \begin{aligned} &(\lambda x:\mathsf{Nat}\times\mathsf{Nat}.x.2)\;\langle\mathsf{pred}\ 4,\mathsf{pred}\ 5\rangle\\ &\to(\lambda x:\mathsf{Nat}\times\mathsf{Nat}.x.2)\;\langle3,\mathsf{pred}\ 5\rangle &&{\small(\text{E-App2})}\\ &\to(\lambda x:\mathsf{Nat}\times\mathsf{Nat}.x.2)\;\langle3,4\rangle &&{\small(\text{E-App2})}\\ &\to\langle3,4\rangle.2 &&{\small(\text{E-AppAbs})}\\ &\to4 &&{\small(\text{E-BetaPair2})}. \end{aligned} $$
Prvé použitie E-App2 má premisu E-Pair1 a druhé premisu E-Pair2; v oboch sa predchodca počíta podľa E-PredSucc. Tretí krok dosadí dvojicu hodnôt za $x$ do tela $x.2$ a štvrtý vyberie jej druhú zložku.
Príklad
V OCamli zapisujeme dvojicu ako (t1, t2) a jej typ pomocou *:
# (1, true);;
- : int * bool = (1, true)
# fst;;
- : 'a * 'b -> 'a = <fun>
# snd;;
- : 'a * 'b -> 'b = <fun>
# fst (1, true);;
- : int = 1
# snd (1, true);;
- : bool = true
Funkcie fst a snd zodpovedajú prvej a druhej projekcii. OCaml však neurčuje poradie vyhodnocovania zložiek dvojice; poradie zľava doprava je voľbou nášho formálneho modelu.
Súčin $n$ typov: N-tica
Binárny súčin zovšeobecníme na konečný súčin $n$ typov. Najprv uvažujme trojicu:
Príklad
Pre trojicu platí $\vdash\langle1,2,\mathsf{true}\rangle:\mathsf{Nat}\times\mathsf{Nat}\times\mathsf{Bool}$. Je už hodnotou a jej tretia projekcia sa vyhodnotí jedným krokom:
$$\langle1,2,\mathsf{true}\rangle.3\to\mathsf{true}.$$
Počet zložiek ani ich typy nemusia byť vždy rovnaké; napríklad:
$$\vdash\langle\mathsf{false},365,\mathsf{true},\mathsf{unit}\rangle: \mathsf{Bool}\times\mathsf{Nat}\times\mathsf{Bool}\times\mathsf{Unit}.$$
Všeobecne má konštruktor $n$-tice tvar $\langle t_1,\ldots,t_n\rangle$ a jej typ zapisujeme $T_1\times\cdots\times T_n$. Tu ide o priamo zavedený $n$-árny súčin. Trojicu $\langle t_1,t_2,t_3\rangle$ syntakticky nestotožňujeme s vnorenou dvojicou $\langle\langle t_1,t_2\rangle,t_3\rangle$.
Pre stručný zápis pravidiel použijeme indexovú notáciu:
$$ \begin{aligned} \langle T_i~^{i\in1..n}\rangle&\quad\text{označuje typ }T_1\times\cdots\times T_n,\\ \langle t_i~^{i\in1..n}\rangle&\quad\text{označuje term }\langle t_1,\ldots,t_n\rangle. \end{aligned} $$
Index $i$ prechádza pozície $1,\ldots,n$. Horný index v tejto notácii znamená opakovanie položiek, nie umocňovanie. Analogicky zapisujeme $n$-ticu hodnôt $\langle v_i~^{i\in1..n}\rangle$. Projekcia $t.j$ vyberá $j$-tu zložku; na výber z $n$-tice musí platiť $1\le j\le n$.
Nulárny súčin. Pripustíme aj $n=0$. Množina indexov $1..0$ je prázdna, takže dostaneme prázdnu $n$-ticu $\langle\rangle$ a jej typ $\langle\rangle$. Rovnaké zátvorky tu označujú term alebo typ podľa miesta v zápise. Prázdna $n$-tica je hodnotou a nemá žiadnu projekciu.
Nulárny súčin má jedinú hodnotu, preto má prirodzenú interpretáciu jednotkového typu:
$$\text{prázdny súčin}\cong\mathsf{Unit}.$$
Symbol $\cong$ vyjadruje izomorfizmus, nie doslovnú rovnosť syntaxe. Hodnoty môžeme prevádzať funkciami $\lambda u:\mathsf{Unit}.\langle\rangle$ a $\lambda p:\langle\rangle.\mathsf{unit}$; na jediných hodnotách oboch typov sa tieto prevody navzájom vracajú. Jednotkový typ tak dáva nulárnemu súčinu aj praktický význam, ktorý sme videli pri výpise v OCamli.
Unárny súčin. Pre $n=1$ rozlišujeme číselnú hodnotu $5$ a jednoprvkovú $n$-ticu $\langle5\rangle$. Majú odlišné typy: $\vdash5:\mathsf{Nat}$ a $\vdash\langle5\rangle:\langle\mathsf{Nat}\rangle$. Nasledovník vyžaduje argument typu $\mathsf{Nat}$, preto ho nemožno priamo použiť na $\langle5\rangle$. Najprv vyberieme zložku: $\langle5\rangle.1\to5$.
Toto rozlíšenie vyplýva z našej syntaxe. OCaml samostatné jednoprvkové $n$-tice nezavádza: (5) je iba číslo v zátvorkách. Iné jazyky môžu jednoprvkové $n$-tice podporovať osobitným zápisom.
Formálne rozšírime syntax o termy, hodnoty a typy $n$-tíc pre $n\ge0$:
$$ \begin{array}{ll} t::=&\ldots\mid\langle t_i~^{i\in1..n}\rangle\mid t.j,\\ v::=&\ldots\mid\langle v_i~^{i\in1..n}\rangle,\\ T::=&\ldots\mid\langle T_i~^{i\in1..n}\rangle. \end{array} $$
V syntaxi projekcie je $j$ kladný číselný index, nie term, ktorý by sa počas výpočtu vyhodnocoval.
Typovacie pravidlá:
$$ \frac{\Gamma\vdash t_i:T_i\quad(\text{pre každé }i\in1..n)} {\Gamma\vdash\langle t_i~^{i\in1..n}\rangle:\langle T_i~^{i\in1..n}\rangle} \quad{\small(\text{T-Tuple})} $$
$$ \frac{\Gamma\vdash t:\langle T_i~^{i\in1..n}\rangle\qquad1\le j\le n} {\Gamma\vdash t.j:T_j}\quad{\small(\text{T-ProjTuple})} $$
Premisa „pre každé $i$“ znamená $i\in1..n$. Pri T-ProjTuple navyše predpokladáme $1\le j\le n$, takže vyberaný typ $T_j$ existuje. Pre $n=0$ nemá T-Tuple žiadnu premisu a prideľuje prázdnej $n$-tici nulárny súčinový typ.
Vyhodnocovacie pravidlá:
$$ \frac{1\le j\le n}{\langle v_i~^{i\in1..n}\rangle.j\to v_j} \quad{\small(\text{E-ProjTuple})} $$
$$ \frac{t\to t'}{t.j\to t'.j}\quad{\small(\text{E-Proj})} $$
$$ \frac{t_j\to t_j'\qquad1\le j\le n} {\langle v_i~^{i\in1..j-1},t_j,t_k~^{k\in j+1..n}\rangle \to\langle v_i~^{i\in1..j-1},t_j',t_k~^{k\in j+1..n}\rangle} \quad{\small(\text{E-Tuple})} $$
E-Tuple zovšeobecňuje E-Pair1 a E-Pair2. Pri kroku $j$-tej zložky musia byť všetky predchádzajúce zložky hodnotami; nasledujúce ešte môžu byť ľubovoľnými termami. V tomto pravidle platí $1\le j\le n$, pričom úsek pred prvou alebo za poslednou zložkou môže byť prázdny.
E-Proj prenáša krok pod projekciu. E-ProjTuple potom vyberie $j$-tu zložku z $n$-tice, ktorej všetky zložky sú hodnotami; predpokladá $1\le j\le n$. Aj tu sa teda pred projekciou vyhodnotí celá $n$-tica.
N-tice a záznamy sú prirodzenými príkladmi konečných súčinov rôznych typov. Bežné homogénne pole (array) má naproti tomu všetky prvky jedného typu a prístup k nim sa typicky riadi indexom vypočítaným za behu. Nie je priamym ekvivalentom heterogénnej $n$-tice s pevne určenými typmi jednotlivých pozícií.
Príklad
V OCamli má trojica nasledujúci zápis a typ:
# (1, true, 4.2);;
- : int * bool * float = (1, true, 4.2)
Funkcie fst a snd pracujú iba s dvojicami. Zložku trojice môžeme vybrať rozborom podľa vzoru (pattern matching):
# let third t = match t with
    | (_, _, x) -> x;;
val third : 'a * 'b * 'c -> 'c = <fun>
# third (1, true, 4.2);;
- : float = 4.2
Podčiarkovníky vyjadrujú, že prvé dve zložky pri výbere nepoužijeme.
Záznam
Záznam (record) zovšeobecňuje $n$-ticu pridaním návestí (labels), ktoré pomenúvajú jej položky. Podobné štruktúry poskytujú mnohé programovacie jazyky, napríklad OCaml, Haskell či Rust.
Položka záznamu má tvar $lab=t$, kde $lab$ je návestie a $t$ term. V type záznamu jej zodpovedá položka $lab:T$. Projekcia $t.lab$ vyberá zložku podľa návestia namiesto číselnej pozície.
Predpokladáme spočítateľnú množinu návestí $\mathcal{L}$. V jednom zázname aj v jeho type sú návestia navzájom rôzne. Návestia nie sú premenné: nezavádzajú väzbu a substitúcia ich nemení.
Príklad
Pre uzavreté záznamy platia nasledujúce typovacie úsudky. Pri druhom predpokladáme doplnenie $\mathsf{String}$ do množiny $\mathcal{B}$ spolu s reťazcovými hodnotami a ich typovacím pravidlom:
$$ \begin{aligned} \vdash\langle x=5\rangle&:\langle x:\mathsf{Nat}\rangle,\\ \vdash\langle meno=\text{"Tichomír"},vek=25\rangle&:\langle meno:\mathsf{String},vek:\mathsf{Nat}\rangle. \end{aligned} $$
Ide o ilustráciu ďalšieho rozšírenia; pravidlá pre záznamy sa tým nemenia. Projekcie sa vyhodnotia takto:
$$ \begin{aligned} \langle x=5\rangle.x&\to5,\\ \langle meno=\text{"Tichomír"},vek=25\rangle.vek&\to25,\\ \langle meno=\text{"Tichomír"},vek=25\rangle.meno&\to\text{"Tichomír"}. \end{aligned} $$
Všetky položky sú tu už hodnotami, takže možno priamo použiť pravidlo projekcie.
Syntax rozšírime podobne ako pri $n$-ticiach:
$$ \begin{array}{ll} t::=&\ldots\mid\langle lab_i=t_i~^{i\in1..n}\rangle\mid t.lab,\\ v::=&\ldots\mid\langle lab_i=v_i~^{i\in1..n}\rangle,\\ T::=&\ldots\mid\langle lab_i:T_i~^{i\in1..n}\rangle. \end{array} $$
Platí $n\ge0$, $lab_i\in\mathcal{L}$ a $lab_i\ne lab_j$ pre $i\ne j$. Indexový zápis opäť označuje celý zoznam položiek. Záznam je hodnotou práve vtedy, keď sú hodnotami všetky jeho položky.
Typovacie pravidlá:
$$ \frac{\Gamma\vdash t_i:T_i\quad(\text{pre každé }i\in1..n)} {\Gamma\vdash\langle lab_i=t_i~^{i\in1..n}\rangle:\langle lab_i:T_i~^{i\in1..n}\rangle} \quad{\small(\text{T-Rcd})} $$
$$ \frac{\Gamma\vdash t:\langle lab_i:T_i~^{i\in1..n}\rangle\qquad1\le j\le n} {\Gamma\vdash t.lab_j:T_j}\quad{\small(\text{T-ProjRcd})} $$
T-Rcd určuje typ každej položky v tom istom kontexte $\Gamma$. V T-ProjRcd musí vyberané návestie $lab_j$ patriť do typu záznamu, teda $1\le j\le n$. Jeho jedinečnosť zaručuje jednoznačný výsledný typ $T_j$.
Vyhodnocovacie pravidlá:
$$ \frac{1\le j\le n}{\langle lab_i=v_i~^{i\in1..n}\rangle.lab_j\to v_j} \quad{\small(\text{E-ProjRcd})} $$
$$ \frac{t\to t'}{t.lab\to t'.lab}\quad{\small(\text{E-Proj})} $$
$$ \frac{t_j\to t_j'\qquad1\le j\le n} {\langle lab_i=v_i~^{i\in1..j-1},lab_j=t_j,lab_k=t_k~^{k\in j+1..n}\rangle \to\langle lab_i=v_i~^{i\in1..j-1},lab_j=t_j',lab_k=t_k~^{k\in j+1..n}\rangle} \quad{\small(\text{E-Rcd})} $$
E-Rcd vyhodnocuje položky zľava doprava. Pred krokom $j$-tej položky musia byť všetky predchádzajúce položky hodnotami. E-Proj prenáša krok pod projekciu; E-ProjRcd vyberie hodnotu s návestím $lab_j$ až po vyhodnotení všetkých položiek. Aj tu platí $1\le j\le n$ a vyberané návestie sa v zázname musí nachádzať.
Poznámka
Význam poradia položiek je voľbou pri návrhu konkrétneho formálneho jazyka. Porovnajme:
$$\langle meno=\text{"Boleslav"},vek=28\rangle \quad\text{a}\quad \langle vek=28,meno=\text{"Boleslav"}\rangle.$$
1. Poradie nerozlišujeme. Môžeme definovať rovnosť záznamov a ich typov až na permutáciu položiek. Uvedené záznamové hodnoty potom predstavujú ten istý záznam a typy $\langle meno:\mathsf{String},vek:\mathsf{Nat}\rangle$ a $\langle vek:\mathsf{Nat},meno:\mathsf{String}\rangle$ stotožníme.
2. Poradie rozlišujeme. Uvedené zápisy sú rôzne termy a ich typy sú tiež rôzne. Od tejto chvíle budeme aj v ďalšom výklade používať tento druhý model. Pravidlá typovania zachovávajú poradie položiek a rovnosť typov ich ľubovoľne nepreusporadúva. Vyhodnocovanie zľava doprava sa riadi poradím v terme.
V oboch modeloch projekcia vyhľadáva položku podľa návestia. Rovnosť typov a poradie vyhodnocovania sú však samostatné súčasti návrhu; pri pridaní účinkov by bolo potrebné výslovne určiť aj ich vzájomný vzťah.
Príklad
V OCamli najprv deklarujeme konkrétny pomenovaný typ záznamu:
# type student = { meno : string; vek : int };;
type student = { meno : string; vek : int; }
# let ab123bc = { meno = "Budislav"; vek = 19 };;
val ab123bc : student = {meno = "Budislav"; vek = 19}
# ab123bc.meno;;
- : string = "Budislav"
# ab123bc.vek;;
- : int = 19
Projekcie tiež používajú návestia, ale pravidlá rovnosti typov OCaml sa nezhodujú s naším modelom. Položky pri vytvorení záznamu môžeme zapísať aj opačne:
# let iny = { vek = 19; meno = "Budislav" };;
val iny : student = {meno = "Budislav"; vek = 19}
Typ zostáva student. Poradie vyhodnocovania výrazov v položkách záznamu navyše OCaml nešpecifikuje; z jeho zápisu preto neodvodzujeme naše formálne pravidlo E-Rcd.
Zhrnutie
Jednotkový typ $\mathsf{Unit}$ má jedinú hodnotu, ale termy tohto typu môžu opisovať výpočty. Zoradenie, zastúpenie, pripísanie a väzba let rozširujú pohodlie povrchovej syntaxe. Ich elaborácia do interného jazyka musí rešpektovať typy aj vyhodnocovanie; pri let sme na doplnenie anotácie využili odvodený typ viazaného termu.
Súčinové typy rozširujú samotnú štruktúru typov. Dvojice, $n$-tice a záznamy spájajú viac zložiek do jedného celku a projekcie z nich údaje vyberajú. Záznamy používajú návestia namiesto číselných pozícií. V zvolenej sémantike sa pred projekciou vyhodnotia všetky zložky zľava doprava; nulárny súčin prepája tieto štruktúry s jednotkovým typom.
Zdroje
- Pierce, Benjamin C.: Types and Programming Languages. MIT Press, 2002. Kapitoly 9 a 11, najmä oddiely 11.1–11.8; pozri aj opravy knihy, najmä k vete 11.3.1 na strane 120.
- Pierce, Benjamin C. a kol.: Software Foundations: More on the Simply Typed Lambda-Calculus. Kapitola o rozšíreniach STLC vrátane jednotkového typu, väzby
let, súčinov a záznamov. - The OCaml Manual, verzia 5.4: Expressions. Typové anotácie, väzby
let, zoradenie, $n$-tice a záznamy. - Novitzká, Valerie; Mihályi, Daniel: Teória typov. TU Košice, 2015.