O údajoch
horizontálne a vertikálne škálovanie, SQL vs NoSQL databázové systémy, časové rady (time series databázy) a ich použitie, zber dát, vizualizácia dát, analýza dát
Poznámka
Slidy z prednášky sú dostupné tu
Úvod
Začnime pohľadom na službu, o ktorej sa rozprávame od začiatku - o chytrom vývoze odpadu (waste management). Trochu preháňajme a uvažujme, že v Košiciach sa nachádza 1000 domov (súpisné čísla). Preháňajme ďalej a povedzme, že pre každý dom máme vyhradený
- 1 kontajner pre papier,
- 1 kontajner pre sklo,
- 1 kontajner pre plasty, a
- 1 kontajner pre komunálny odpad.

To máme dokopy 4000 veľkých kontajnerov v meste. Zatiaľ nič nehovoríme o verejných kontajneroch v parkoch, na zastávkach a podobne. Každý z týchto kontajnerov je v našom scenári vybavený chytrým zariadením (vecou), ktoré vie zistiť množstvo odpadu v kontajneri a v pravidelných intervaloch, ako aj v prípade potreby (množstvo odpadu presiahlo úroveň, kedy ho je potrebné vyviezť) vie odoslať údaje o svojom stave. Ak budeme preháňať ďalej, tak povedzme, že každé zariadenie bude posielať správu o aktuálnom stave každú hodinu. To znamená, že v jednom momente zaznamenáme nápor v podobe 4000 požiadaviek o zápis údajov do databázy.
Poznámka
Toto číslo samozrejme nie je extrémne veľké. Ak by sme však mali senzory, ktoré by snímali údaje napr. každú minútu alebo každých niekoľko sekúnd, množstvo údajov, ktoré je potrebné uložiť, by bolo výrazne vyššie.
V našom scenári sme však stále v jednom meste. Čo ak by sme svoju službu prevádzkovali v niekoľkých mestách zároveň? Čo ak by sme vyhrali nejakú štátnu zákazku a stali by sme sa výlučným poskytovateľom danej služby na Slovensku? Čo ak by sme uvažovali vo veľkom a podarilo by sa nám preraziť za hranicami a službu by sme poskytovali v niekoľkých krajinách? Množstvo údajov čakajúcich na uloženie by rástlo ďalej, vďaka čomu by sa databázový server stal veľmi rýchlo úzkym hrdlom systému.
Hovorili sme o tom, že nápor množstva údajov vieme znížiť vhodným umiestnením vrstvy edge v našej architektúre. Tá nám pomôže znížiť nápor agregovaním údajov, prípadne ich čiastočným predspracovaním alebo aj analytikou.

Horizontále a Vertikálne Škálovanie
Znížiť nápor množstva údajov však môžeme aj výberom vhodného databázového systému s vhodnými vlastnosťami. Databázové servery pre IoT riešenia, ktoré potrebujú spracovávať obrovské množstvá údajov v reálnom čase, by mali byť horizontálne škálovateľné.

Relačné databázové systémy sú tu s nami už od 70-tych rokov. S množstvom uchovávaných údajov sa môžu začať potýkať s problémom potrebného výkonu. Akonáhle sa problémy tohto typu vyskytnú, začnú ich spoločnosti riešiť vertikálnym škálovaním.
Vertikálne škálovanie
Vertikálne škálovať (anglicky tiež scale up/down) znamená pridať ďalšie zdroje (alebo odstrániť existujúce) z jedného uzla (zariadenia). Obyčajne sa jedná o zmenu zdrojov dostupných pre inštanciu v podobe modelu CPU, počtu jadier, kapacity a rýchlosti pamäte RAM alebo kapacity diskového priestoru na jednej inštancii.
Tento spôsob škálovania má prirodzene svoje limity. Bežne sa stretávame s týmito:
- Hardvérový strop je daný architektúrou stroja,
ktorá napríklad udáva maximálnu podporovanú kapacitu pamäte RAM, socket
(ľudovo kontektor na pripojenie) procesora či už len počet
pripojiteľných periférií. Napríklad ak naše zariadenie disponuje CPU
socketom
AM3+, tak najvýkonnejším procesorom ktorý doň vieme osadiť je AMD FX-9590 ktorý disponuje ôsmimi jadrami - viac už fyzicky nedokážeme do nášho stroja pripojiť. - Dostupnosť hardvéru je ovplyvnená vekom. Staršie zariadenia sú vyradzované a v praxi je v momente vyradzovania možné zakúpiť “z druhej ruky” komponenty za nízku cenu, avšak po určitej dobe je komponenty náročné “zhonať” a kvôli ich rarite cena stúpa.
- Single point of failure je najväčším nedostatkom vertikálneho škálovania. Môžeme mať najvýkonnejší server na svete, ak je napájaný z jednej elektrickej siete, tak jednoduchý výpadok elektrickej energie našu architektúru vyradiť z prevádzky. Podobné riziká je možné minimalizovať ale nikdy nie do takej miery ako pri horizontálnom škálovaní.
- Limitácie softvéru či už z pohľadu operačného
systému alebo spustenej aplikácie. Niektoré aplikácie nedokážu efektívne
fungovať na viacerých jadrách, a ak aj fungujú, pri plnej záťaži môžu
vykonávať tak obrovské množstvo operácií že vyčerpajú zdroje operačného
systému (napríklad limit na počet otvorených súborov na čítanie, ktorý
je štandardne
1024ale dá sa upraviť)
Horizontálne škálovanie
- Horizontálne škálovať (alebo tiež scale out/in) znamená pripojiť do systému ďalšie uzly (alebo odpojiť existujúce). To docielime pripojením nového počítača do distribuovaného systému. Vlastnosťou horizontálneho škálovania je vybavená väčšina moderných Cloud Native riešení (viď napr. CNCF Landscape). Medzi tieto služby patria SQL, NoSQL databázy, proxy, mesh siete, distribuované úložiská a mnohé iné.
Najbežnejšie limity v tomto prípade sú:
- Efekt lievika vznikne naškálovaním jednej služby, čo síce odľahčí výkon na jej strane, avšak záťaž sa presunie na iné služby ktoré neboli naškálované. Bežným riešením je súbežné škálovanie napr. web aplikácií, API, databáz a dátových úložísk.
- Desynchronizácia nastáva pri nekorektnej konfigurácii alebo výpadkoch či okrajových scenároch. Nakoľko je kritické aby jednotlivé inštancie vedeli o sebe navzájom, tak takýto stav môže viesť aj k kompletnej nefunkčnosti systému.
- Koordinácia medzi inštanciami prirodzene spôsobuje záťaž na sieť a systémové zdroje. Korektné fungovanie vo väčšine prípadov vyžaduje buď riadiace inštancie alebo možnosť vzájomnej komunikácie medzi všetkými inštanciami.
- Cena a zložitosť je najbežnejším dôvodom prečo sa tieto riešenia v niektorých prípadoch nevyužívajú, keďže financovať, spravovať a monitorovať takúto infraštruktúru je omnoho náročnejšie.
Finálne porovnanie
Samozrejme aj jeden aj druhý prístup má svoje výhody a nevýhody:

| horizontálne škálovanie | vertikálne škálovanie |
|---|---|
| so zvyšovaním počtu pripojených uzlov sa zvyšuje aj dostupnosť | single point of failure |
| pri škálovaní nie je potrebný žiadny výpadok služby | pri zmene konfigurácie je služba nedostupná |
| relatívne nízke náklady | lepší hardvér predstavuje zvýšené náklady |
| škálovať je možné teoreticky do nekonečna | obmedzené možnosti zvyšovania výkonu |
| nie každý softvér a problém je možné riešiť distribuovane | väčšina softvéru zvláda výhody vertikálneho škálovania |
| problémy ako potreba load balancera na distribuovanie požiadaviek, synchronizácia a replikácia údajov, aktualizácia softvéru | jednoduchá správa softvéru na jednom počítači/zariadení |
| automatické škálovanie použitím vhodných služieb (AWS) | automatizácia je možná buď vlastnými skriptami alebo inštalovanými službami |
Relačné databázy
Relačná databáza ukladá údaje do tabuliek. Každá tabuľka zvyčajne opisuje jeden typ veci, napríklad zákazníkov, produkty alebo objednávky. Tabuľky možno prepájať pomocou spoločných identifikátorov.
Z slova relačná vyplýva že v tomto systéme pôjde hlavne o vzťahy, teda už spomínané prepojenia.
- Primárny kľúč jednoznačne identifikuje riadok v tabuľke, napríklad
id. - Cudzí kľúč odkazuje na riadok v inej tabuľke, napríklad
id_produktu. - Takéto prepojenie sa nazýva vzťah medzi tabuľkami.
Relačné databázy ste už používali, takže takýto úvod by na rozpomenutie mal stačiť :)
Databázy časových radov aka. Time Series Database
Senzorické údaje, ktoré zbierame v IoT aplikáciách, sú závislé na čase. Takýto typ databáz sa nazývame time series (časové rady).
Time series databáza (TSDB) je softvérový systém, ktorý je optimalizovaný pre prácu s časovými radmi na základe párov dvojíc čas a hodnota.
Obecne sa teda jedná o údaje, ktoré keď vizualizujeme v podobe grafu, tak jedna z osí reprezentuje čas. Čas tu figuruje ako nezávislá premenná a cieľom je obyčajne predikovať budúcnosť.
Nad dátami tohto typu nás častokrát zaujímajú otázky ako:
- aká bola teplota za poslednú hodinu?
- aká bola teplota za posledných 24 hodín?
- aká bola priemerná teplota za celý minulý rok?
Ich popularita v posledných rokoch prudko stúpla, o čom svedčia aj štatistiky:

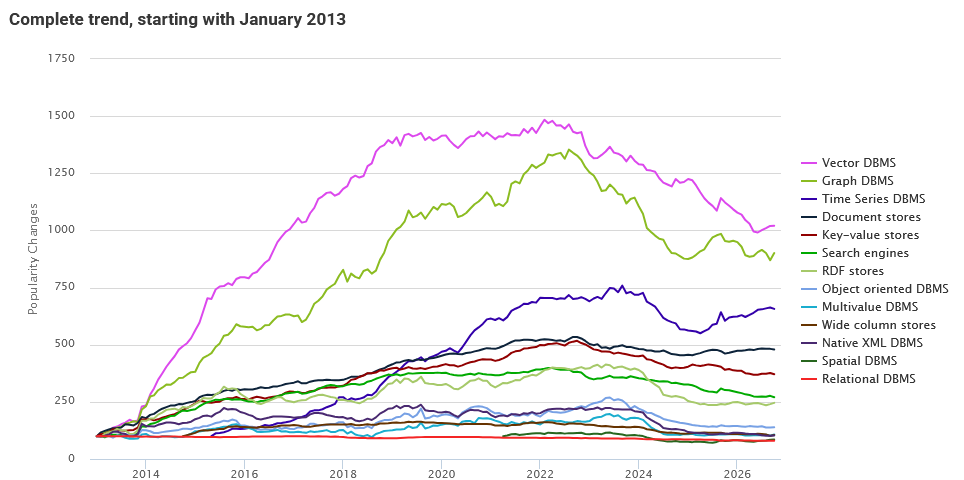
TSDB majú najväčšie uplatnenie v týchto troch oblastiach:
- IoT - senzorické dáta
- DevOps - monitoring
- dátová analytika (v reálnom čase) - metriky
Typy zbieraných dát:
- v pravidelných intervaloch - pravidelné merania
- v nepravidelných intervaloch - udalosti
